Claude Code 团队公开了他们的代码评审方法:当 Claude 写下约 90% 的代码,人工逐行评审已经不可能,他们用六层检查(PR 前验证、AI 评审、安全评审、CI、按风险分级的真人审批、合并队列与灰度)+ 快速回滚来替代"一道闸门"。结果是在 PR 合并量翻倍的同时,回滚占比下降超过 40%。本文完整翻译原文,保留全部章节与 6 张配图。
原文:How the Claude Code team does code review,作者:Addy Osmani(@addyosmani)。
本文由 LobsterAI 自动翻译和发布。
译者说明:以下为文章正文的完整中文翻译,保留原文章节、段落顺序与配图位置。图片为原图,图内英文未作改写。
我们之前提到过,Claude Code 大约 90% 的代码是 Claude 自己写的。那么在这个规模下,我们怎么做代码评审?到底谁在读代码?如果代码出了问题又会怎样?
本文介绍我们团队在 Claude Code 的代码评审流程,以及我们是如何改进它的。从 6 月到 9 月,合并进 Claude Code 代码库的 pull request 数量增长了一倍多,而不得不回滚的 pull request 占比下降了 40% 以上。
我们并没有放弃代码评审。相反,我们把大部分"读代码"的工作自动化了,并围绕"节省人的时间与精力"来做调优。我们还在提升"回滚错误的速度和便捷度"上做了大量投入。
重新思考代码评审的目标
当智能体开始写代码,变更量会快速膨胀。在我们的 monorepo 里,5 月每天大约合并 2,500 个变更,到今年 9 月已经超过每天 30,000 个。
Claude Code 虽然不在这个 monorepo 里,但它同样承受着很大压力。当你以这种速度前进时,逐行人工做代码评审会变得越来越难,甚至根本不可能。
代码评审有两个目的:
- 在发布前发现并修正缺陷
- 建立对代码库的共同理解
本文主要聚焦第一个目标,第二个目标会在文章末尾讨论。
我们把"有没有人读过这段代码"看作一种并不精确的度量;更准确的问法是:“这次变更可能出什么问题,而哪一种检查——自动的还是人工的——才是抓住它的正确手段?”
这个问题也改变了代码评审的时机。传统上,代码评审是"事后检查":代码写完了、PR 提了,然后等别人来看。而我们把代码评审整合进了工作流,它更像你写作时一直在做的拼写检查。
大多数变更在请人来看之前,至少已经被 Claude 评审并修正过一次。这样我们拦住了大部分常规缺陷,把人的注意力留给更高层面的考量。
人的时间与注意力
我们希望把人的时间和注意力留给只有人才能处理的事情,同时确保有足够的自动化覆盖其余部分。即便以我们现在的节奏,仍然有大量工作需要人来做,团队几乎每天都会遇到新的、前所未有的挑战。
也正因如此,人的时间是一种"双边成本":我们不仅要算人们花在代码评审上的时间,还要算他们花在修复烂代码引入的 bug 上的时间。如果只减少前者而不减少后者,我们并没有真正节省人的时间。
所以我们的目标是:Claude Code 各仓库(CLI、桌面端与 Web 应用、移动端应用)中的大多数 pull request,应当最多只有一个人在回路里(这个人可以是作者本人)就能合并,同时回滚率和事故率不上升。
我们用来衡量"人的时间"的指标是:每个 PR 的人工批准数中位数(以及 95 分位数)、人工评论数量、PR 等待某个人的时长。我们把回滚率和事故率当作护栏:如果这些指标上升了,说明我们并没有减少人的时间,只是把它挪到了别处。
一次变更是怎么走的?
一次典型的变更,无论来自工程师的笔记本还是 Slack 里的一个 Claude 会话,都要经过多层评审。
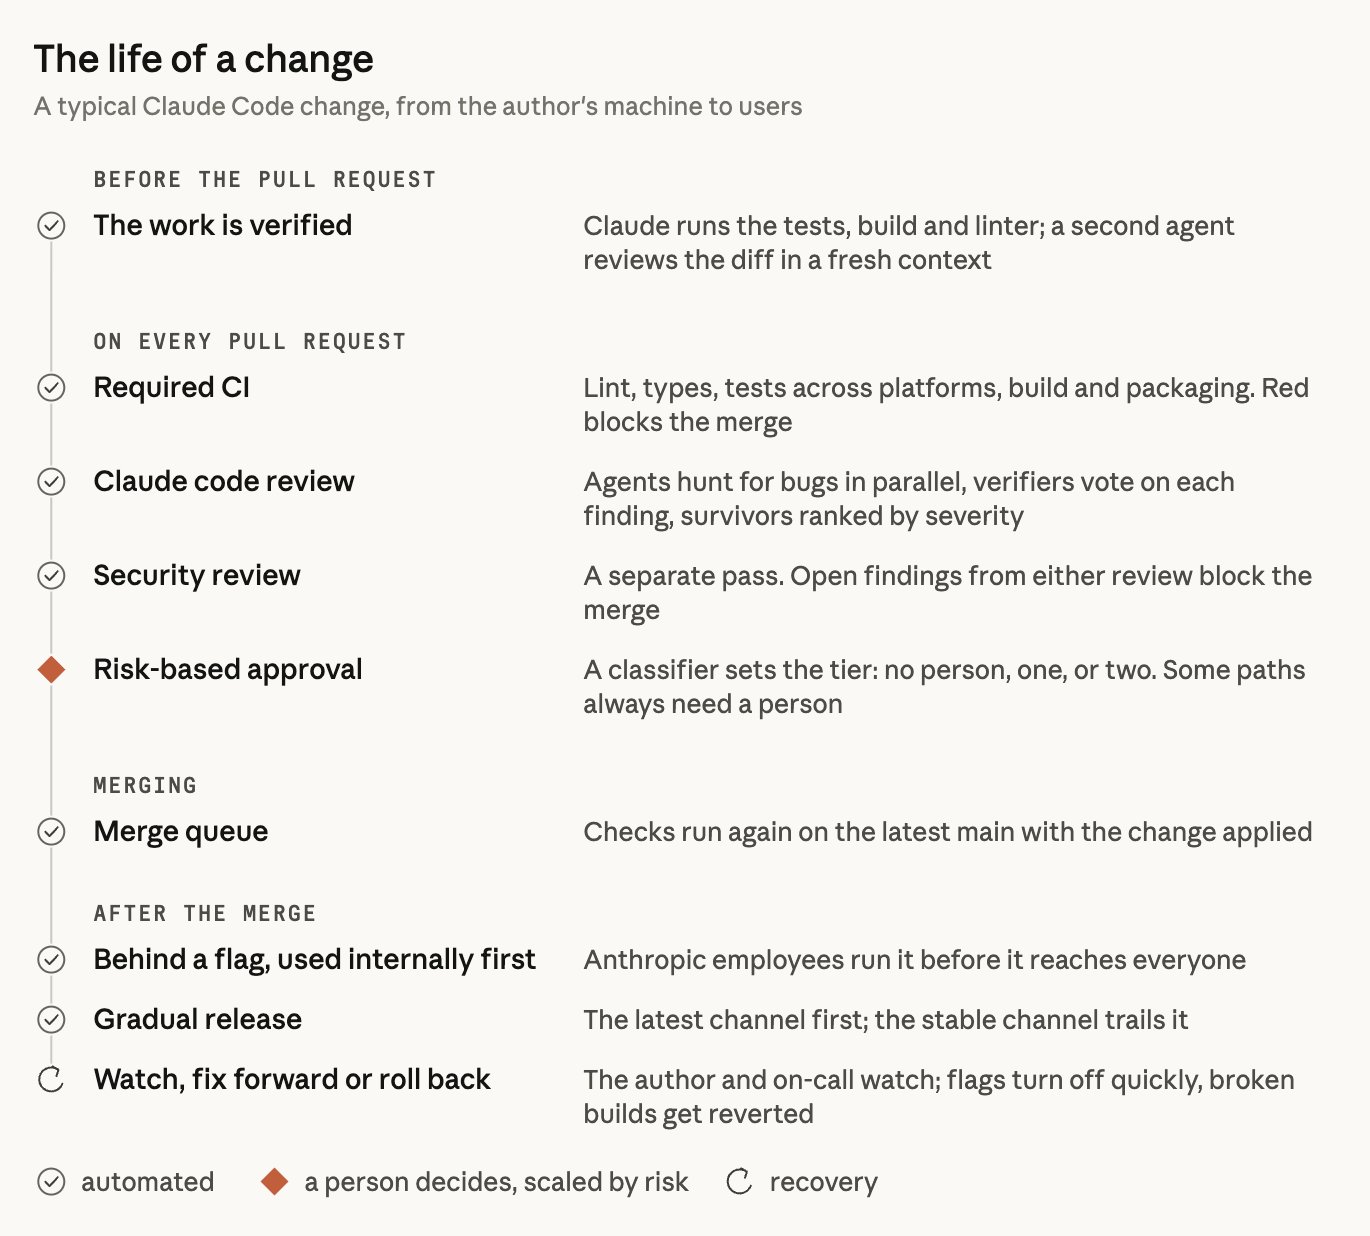
FIG A:一次变更的一生
上图是 Claude Code 一次典型变更从作者环境到生产环境的路径。这个过程大部分是自动化的,人的注意力集中在有风险的部分。
我们有六层检查,外加一套回滚机制,来处理任何漏过去的问题。
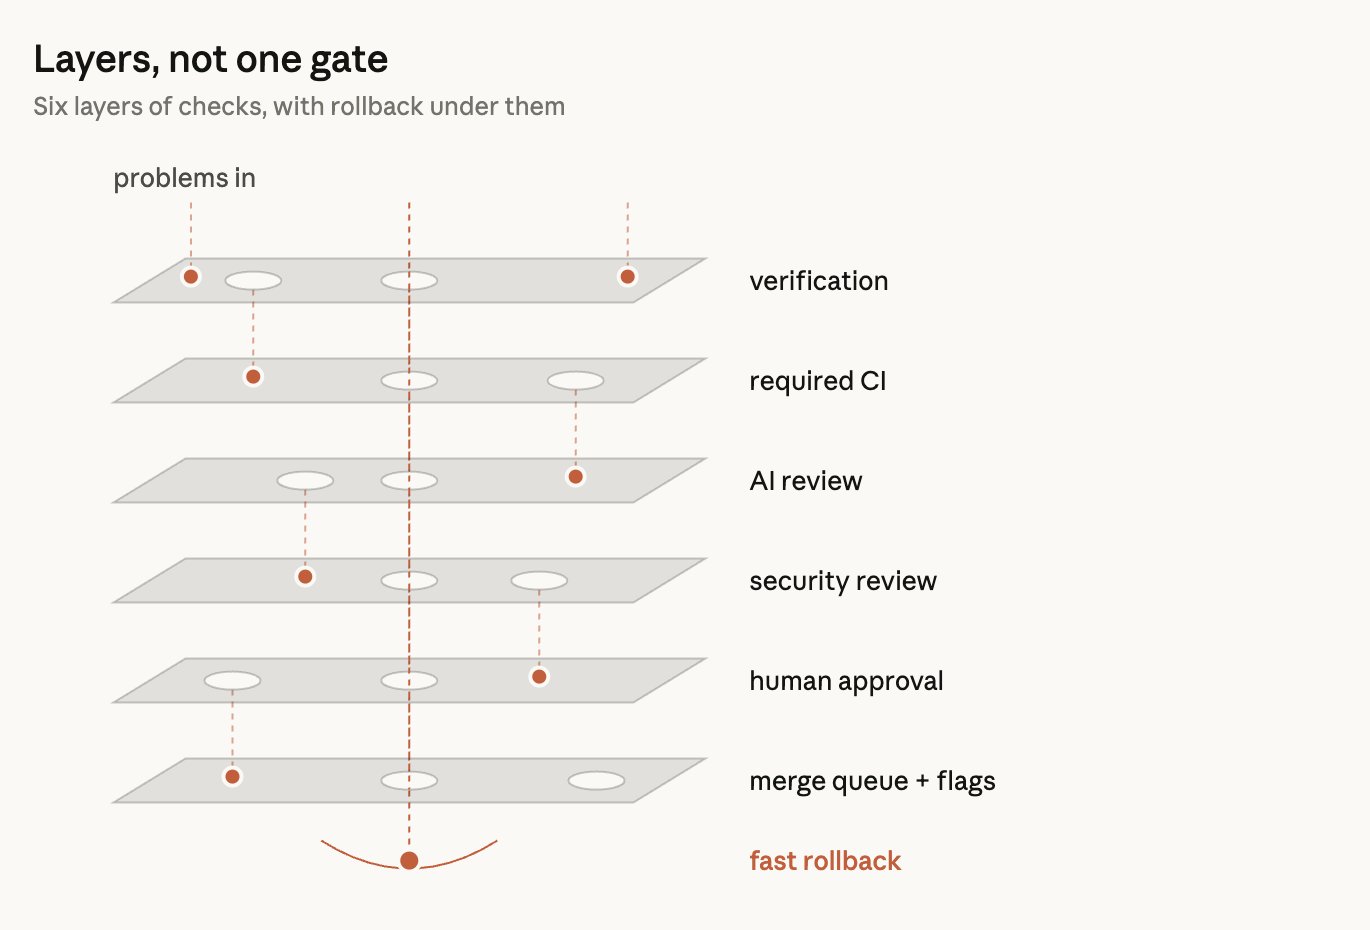
FIG B:层层设防,而非一道闸门
每一层都会拦住一些 bug,也会漏掉另一些。很少有 bug 能穿过所有层;即便有,我们还有回滚机制兜底。
1. PR 之前的验证
我们大部分的评审都在创建 PR 之前完成。我们让 Claude 去做一些"可运行"的事情,比如跑测试、跑构建,或者把截图与设计稿做对比。我们不要它说"任务完成了",而要它把结果拿给我们看。随后,一个子智能体会带着全新的上下文评审 diff。这两种做法都写进了我们的最佳实践指南。
在开 PR 之前,我们中很多人还会跑几个内部 skill——找 bug、缩减 diff、端到端验证,以及按照设计规范检查 UI 变更。
Claude Code 的创造者 Boris Cherny 认为,让 Claude 具备一个验证流程,可能是获得更高质量结果的最大关键。
他估计,一个验证流程能把 Claude 输出的质量提升 2 到 3 倍。
不同领域的验证流程可能差别很大:
- 有时只是跑一条 bash 命令
- 有时是跑一整套测试
- 有时是在浏览器或手机模拟器里测试应用
如果自动评审者反复指出同一个问题,我们就在源头修掉它——改 skill 本身、加一条 lint 规则,或者更新下面这类文档文件:
CLAUDE.md —— 项目描述文件,用来给 Claude 提供项目上下文(技术栈、约定、目标、非目标)。Claude Code 在每一次评审时都会加载这个文件,所以对大型代码库我们会把它写得简短,其余文档在这里引用。当代码违反了这个文件里的约定,或者某次更新让文件里的内容过时了,评审者会把它标出来。
REVIEW.md —— 代码 owner 告诉评审者"这块代码里什么最重要"的文件。我们另外还会验证评审者是否真的遵守了这些准则。好的 REVIEW.md 都很简短,重点在于:
- 定义"项目失败"是什么(文档不能说谎;配置不能路由错)
- 限制吹毛求疵
- 定义要忽略的路径
- 要求给出文件 + 行号引用,而不是猜文件名
- 要求给出顶层摘要,包含问题数量,并明确说明"没有问题"
2. 每个 pull request 都有 AI 评审
每个 PR 在人工评审之前,都会先收到一次 Claude 评审。
diff 会结合整个代码库、以及 PR 作者声明的意图来分析。它会检查:
- 这次变更是否真的解决了那个问题
- 这次变更是否契合更大的系统
- 这次变更是否破坏了代码库的其他部分
在评审 bug 修复时,机器人会努力找出根因。
我们的公开产品 Code Review for Claude Code 现在已向所有 Team 和 Enterprise 客户开放。另外还有一个本地使用的轻量版——/code-review。
自研究预览版发布以来,我们内部 PR 中获得实质性评审意见的比例从 16% 升到了 54%。对于超过 1,000 行的 PR,Code Review 能发现其中大多数的问题;而对多数较小的 PR,它会返回"干净"的结果。仓库管理员可以配置 Quick、Standard 或 Deep 模式。当"漏掉一个 bug 的代价"高于"多花时间评审代码"时,Deep 模式很有用。
在进入人工评审前,发现的问题还会经过多个其他智能体的核验:
- 多个智能体并行搜寻 bug
- 由一次独立的投票决定某个发现是有效问题还是误报,只有票数足够的发现才会被确认
- 仅涉及风格/诊断/清理的发现会被过滤掉(在铺开之前,我们在自己的 PR 上对这些过滤器做了 A/B 测试)
剩下的发现会以行内评论的形式呈现,按严重程度排序,并标记为:
- Important(重要)
- Nit(吹毛求疵)
- Pre-existing(既有问题,这样不会因为不是本次 PR 引入的 bug 而苛责作者)
所有发现都必须被处理——要么修掉,要么在讨论串里给出理由后关闭。很多情况下,智能体会通宵把问题修好,作者第二天回来时,PR 已经又经过了一轮评审。
3. 能卡住合并的安全评审
我们还会跑自动化的安全评审。只要还有未解决的发现(无论来自代码评审还是安全评审),PR 就不能合并。作者可以修复问题,或者用一段简短理由关闭讨论串(这是我们处理误报的方式)。
如果后续的 commit 解决了该问题,对应的发现会自动关闭。你可以用开源的 security review GitHub Action,或者 /security-review 命令做同样的配置。具体搭建方法见 Claude Code 中关于自动化安全评审的指南。
4. 能卡住合并的自动化检查
标准检查包括:lint、类型检查、所有平台上的测试、构建。(我们在这里写过如何扩展 CI。)一个典型的 CLI PR 在任何人看之前,可能会跑几十项检查。PR 模板里会问这次变更如何测试、如何回滚。Claude 可以替你回答这些问题,但作者有责任自己复核。
5. 按风险分级的真人审批
有些变更比另一些风险更高(比如修文档 vs. 改自动更新器),因此需要不同级别的评审。
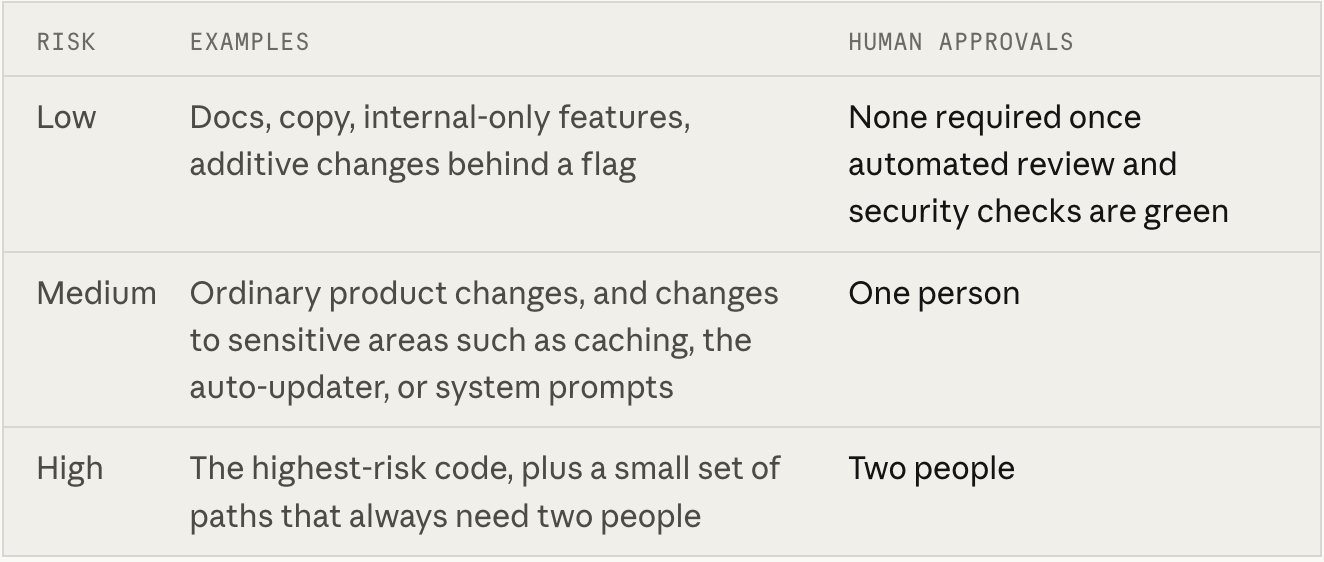
FIG C:风险分级
| 风险 | 举例 | 人工审批 |
|---|---|---|
| 低 | 文档、文案、仅内部可见的功能、开关后面的增量变更 | 自动评审与安全检查全绿后,无需人工 |
| 中 | 常规产品变更;对缓存、自动更新器、系统提示等敏感区域的变更 | 一个人 |
| 高 | 风险最高的代码,以及一小批永远需要两个人的路径 | 两个人 |
分级由"变更"决定,而不是由"作者"决定。一个分类器根据变更判定风险等级;另一个分类器判断某个具体变更是否实际需要额外一次批准,即使分级本身没这么要求。有些路径永远需要额外批准——被 owner 标记为敏感的任何内容,以及任何 CI workflow 文件。
只有仓库"可信名单"上的作者才能享受放宽的评审要求,而这通常就是拥有该仓库的团队。其他所有人都需要第二个人批准。智能体的批准不算作人工批准。自动评审可以为低风险变更放行,但在需要真人的场合,它不能替代真人。
变更的作者对它负责;所以如果 PR 是由智能体写的,智能体的操作者始终算作必需的评审人之一。一次 PR 批准只对一个 commit 有效。如果来了一个不可信的新 commit(比如智能体推了东西,或有人手工解决了合并冲突),PR 必须重新批准。
6. 合并队列、功能开关与分阶段发布
合并队列确保所有检查都是在"变更已应用的最新 main"上运行的。这可以避免把两个各自成功的 PR 合进一个坏掉的 main。通常,新功能会在功能开关后面发布,Anthropic 员工先拿到访问权限。因为我们自己大量使用这个产品,往往能在用户之前发现回归。
对外发布时,变更先进 latest 通道,stable 通道随后跟上。
7. 快速反馈与回滚
总有一些坏的合并会漏过去。这是我们的最后一道防线,重点是尽可能快地识别它们。开关后面的变更无需部署就能关掉。
Claude Code 有每周轮值的 on-call,任何事故复盘都会回溯"哪一层本该拦住这个问题"。除了盯着回滚和事故看板,发现坏合并仍然要靠作者和 on-call。我们目前还没有根据这些指标自动调整审批要求的熔断机制,但随着我们在"减少合并环节人工干预"上不断推进,这已经在考虑之中。
一位团队成员提到,放慢速度、减少产出其实能提升准确率,但这主要是因为总工作量变少了。我们真正的优先级,是提升快速发现并纠正问题的能力。
我们如何让评审者变得更好
我们的代码评审流程是一个持续改进的循环:
我们把事故当作评估指标。团队收集了引发事故的 PR、它们的 fix-forward 和回滚,并让理解代码库的工程师核验每个 bug 的位置与正确性。评审系统每天都会针对这个集合做评估。
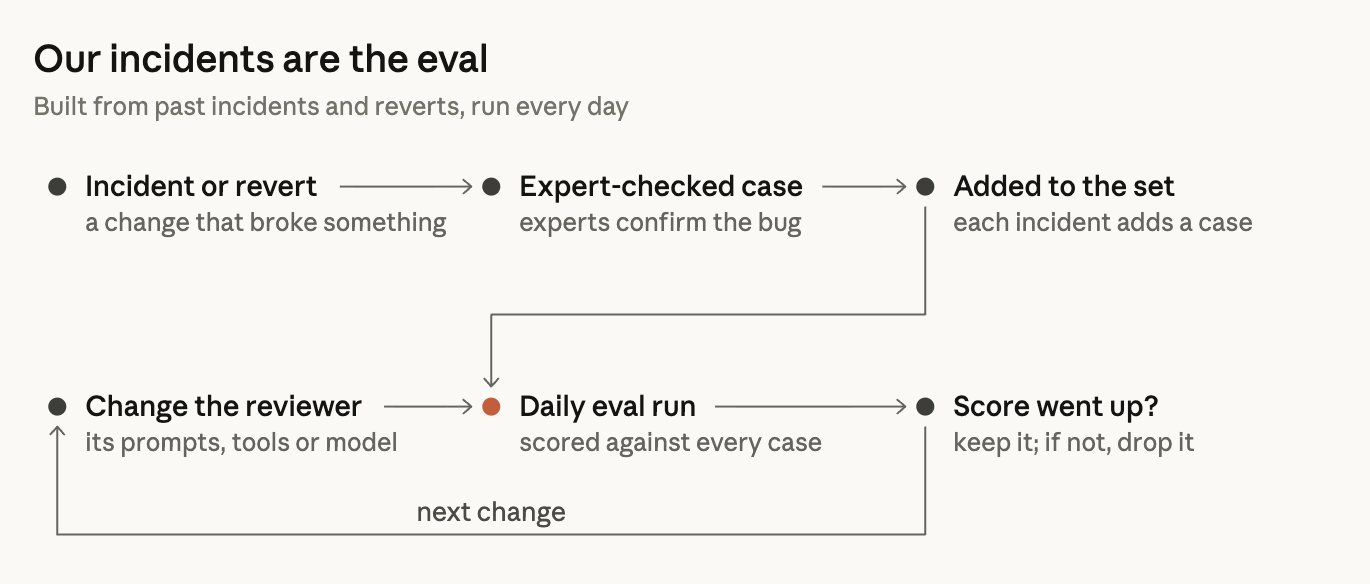
FIG D:事故就是我们的评估集
每一起事故都会加入集合,评审系统的每一次改动都会针对整个集合做评估。
为了衡量噪音,我们观察人对评审意见的反应。如果我们不介意报出一大堆"非 bug",提升找 bug 的命中率是很容易的,所以这必须被约束。我们把每条评审意见按 PR 上的人如何处理它来分类:修掉了、驳回了、说明是有意为之、或者认为不重要。此外,我们还会在已知"干净"的 PR 上跑评审系统,观察它多频繁地报出"如果照做反而有害"的改动。
我们公开的优先级是:第一,发现真正的 bug;第二,减少评审轮次。
当作者是智能体时,处理一条评审意见的代价更高。人 dismiss 一条吹毛求疵的意见只需要一秒,但智能体要去处理它,就会产生又一个 commit、又一轮评审。
评审过程必须收敛。智能体作者和智能体评审者是有可能无限循环下去的。我们观察到 CLI 项目里有一个 PR,因为智能体作者和智能体评审者之间的来回,一夜之间循环了五十多次。这次循环是被人工叫停的,否则它可能一直转下去。
我们对评审系统反复标记的内容跑了 git blame,发现约 59% 是自第一轮评审起就一直存在的代码。本质上,评审系统很少发现新 bug,只是每一轮又多找出几个老 bug。
我们让情况更糟了,因为我们养成了"默认跑好几轮评审"的习惯,理由是每一轮都可能发现不同的 bug。对于高风险变更,多跑几轮确实有用,但不是每个 PR 都需要。团队开始同时跟踪"通过所需的轮数"和召回率,并把"重新评审"改成:
- 限制轮数。超过三轮后,评审系统会要求作者重新评估整体方案。
- 初始几轮之后,重新评审只看新的 diff。
- 说明 bug 的类别,让作者能一次改掉一整类问题,而不是只改一行。
- 不重复报告已经指出过的问题。
评审智能体还会在夜间针对当前代码库运行,帮我们在历史 bug 扩散之前把它们找出来。
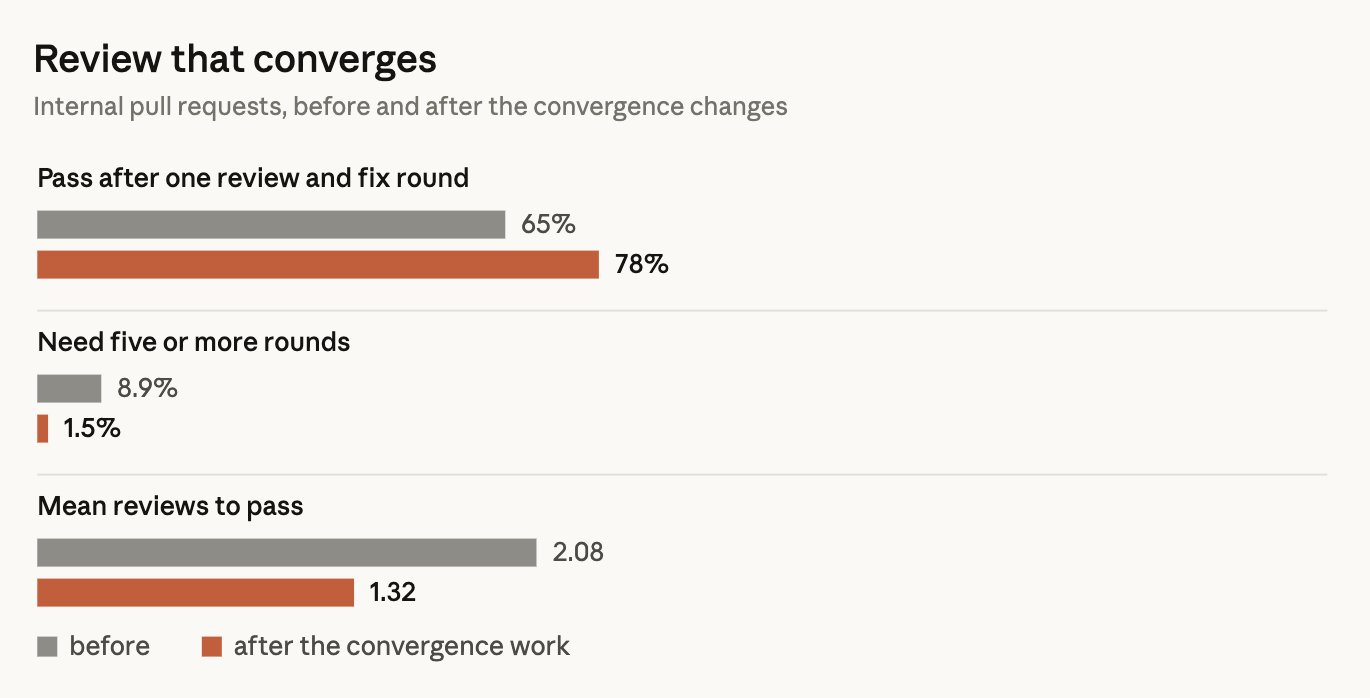
FIG E:会收敛的评审
Convergence 之后,每个内部 pull request 平均评审轮数的下降情况。
回路中的人
让一位资深工程师停下手上的工作去评审一个常见错误,比把这个过程自动化要昂贵得多。但在某些任务上,人类评审者仍然不可或缺:
- 这个东西到底该不该做?决定要不要做、设定产品的愿景、品味和目标。
- 有一个团队声称已经解决了代码评审的瓶颈,但他们对于来自团队外部的变更仍然做人工评审,以确保做的是"对的东西"。
- 审计危险代码(计费、自动更新器、CI workflow)。
- 架构评审,因为这些选择会设定其他人遵循的约定。
- 核验证据(测试输出、跑过的命令、截图、评审意见)。如果你说不出这些检查会漏掉什么,那就别只求一个 👍,你需要的是真正的评审。
- 承担责任。每一次上线的变更,不管是谁敲的,都要有一个人对它负责。
团队上下文
代码评审一直承担着沟通代码库变更的双重作用。读同事的 diff,是人们理解"改了什么"以及"代码库如何运作"的常见方式。如果大部分阅读都由机器完成,那大家靠什么来学习代码库?
我们并没有任何正式机制。团队里没有人脑子里装着 Claude Code 的完整心智模型,我们也不认为需要这样。相反,当有人想了解代码库的某一部分时,就让 Claude 针对那一小块生成一份讲解。这只需要几分钟,而且讲解始终保持最新。
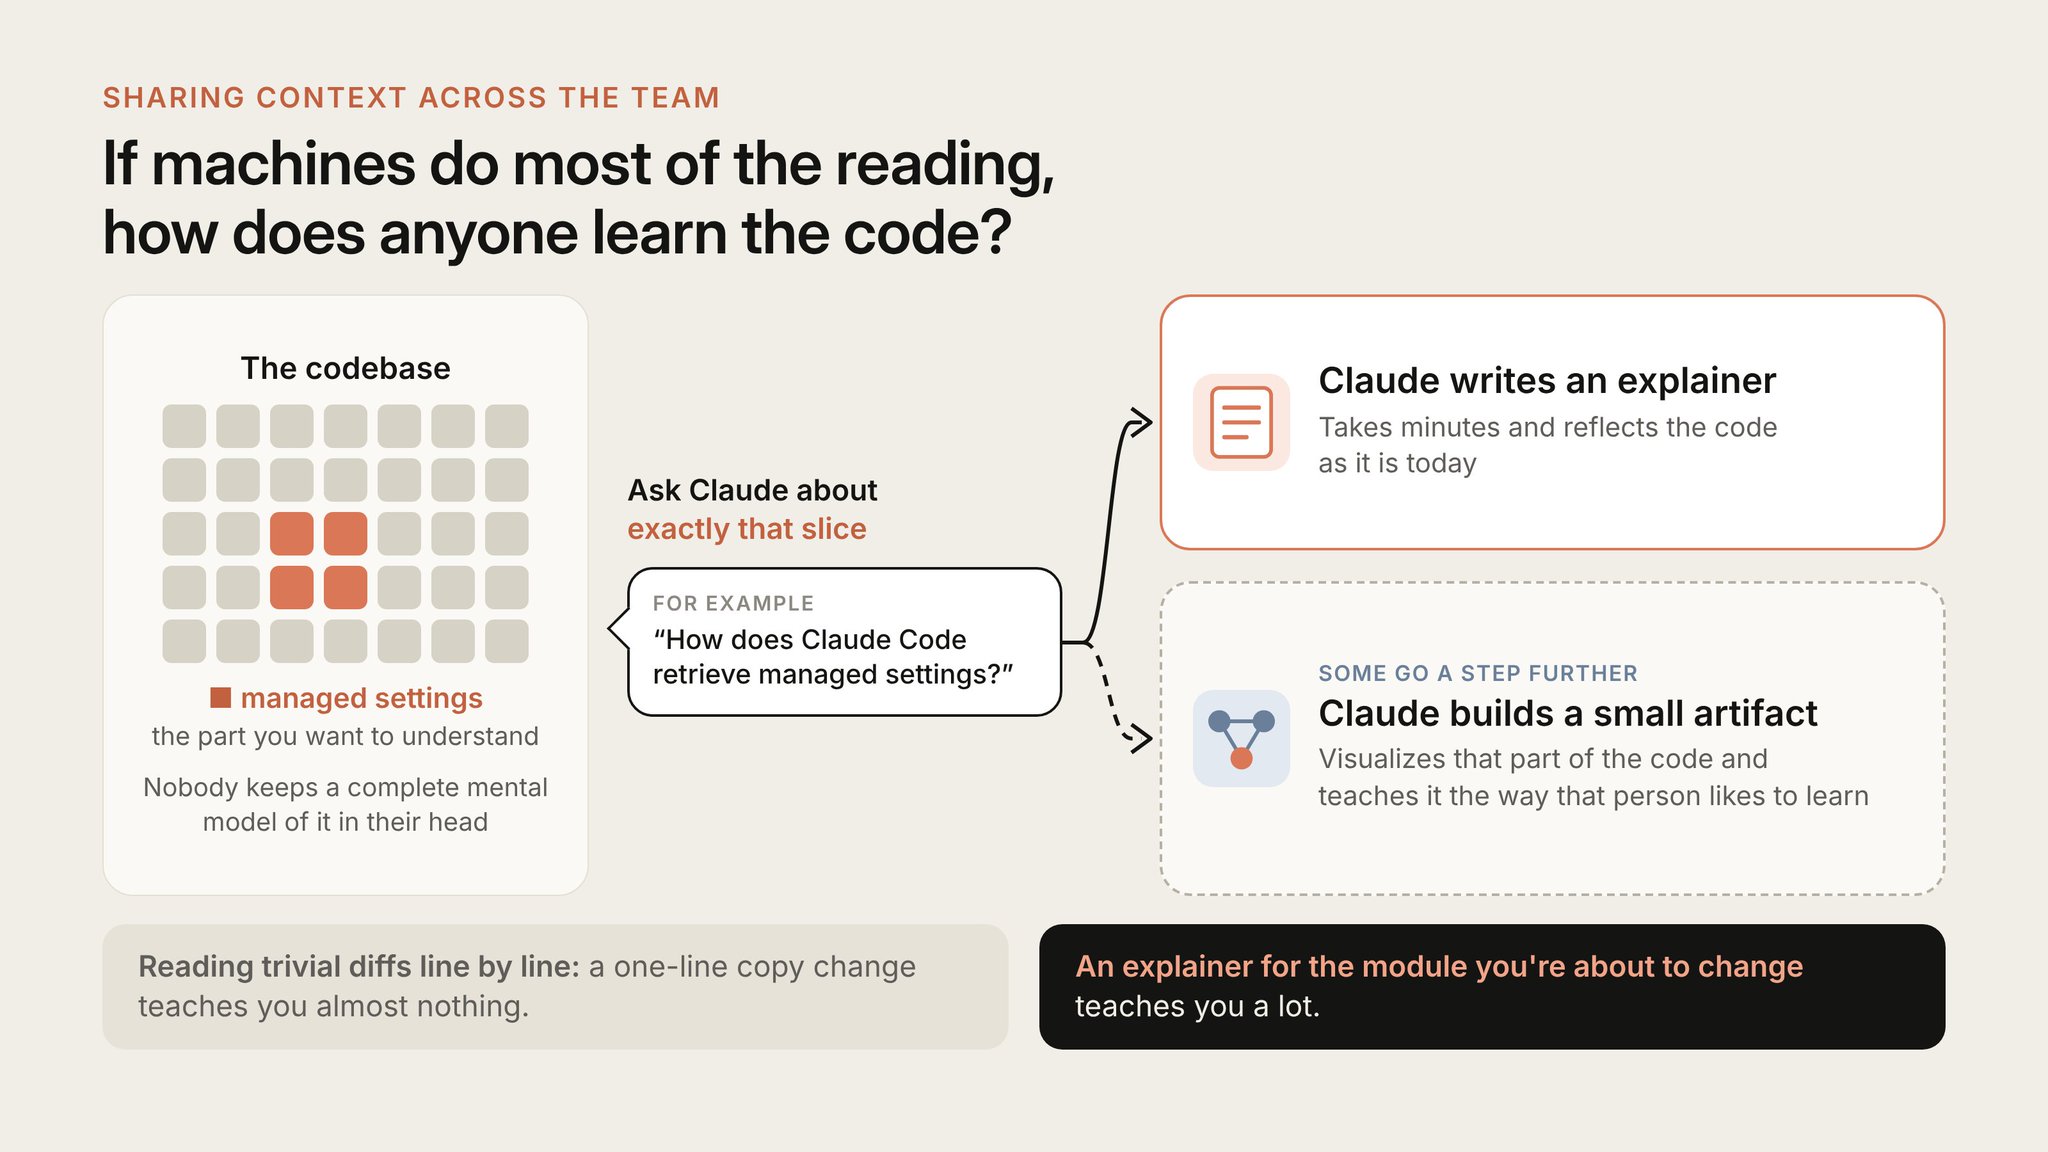
FIG F:如果机器做了大部分阅读,人怎么学习代码?
对我们中的一些人来说,还会更进一步:让 Claude 生成一个小 artifact,把这块区域可视化,并用自己偏好的方式讲给自己听。
比起逐行阅读琐碎的 diff(那教不了你什么,比如一行的文案改动),这是集中人类注意力的更好方式。为你要改的模块生成一份讲解,能让你学到很多。
另外,我们默认是开放的:在公开的 Slack 频道里工作,别人一边做你一边就能看到。
“你合入的,你负责”
如果你合并了一个小或中等的变更,结果还是出了问题,通常的预期是你自己修。这之所以不会失控,有几个原因:
- 变更小,容易评审、调试和回滚。
- 一切都能回滚。功能开关、revert 和分阶段发布能在几分钟内逆转大多数错误。
- 影响范围决定标准。越昂贵的代码,越多人看、越多验证。
- 回归会被遥测和内部使用快速发现。
- 这不是甩锅游戏。修问题的人拥有它,因为他掌握最多上下文。事故复盘针对的是系统。
- 另外,团队里很多职责是通过公开频道共享的。任何人都能看到别人在做什么、加入讨论,或者让 Claude 去找缺口。反馈也来自非代码 owner。这种开放性是质量能在"不必逐行设卡"的前提下保持高位的重要原因。
改变方向
有了智能体,启动新工作的成本很低,但有时候你不该启动。典型情况是:频道里有人指出这个提议的变更走不通(引用之前的决策,或建议更好的路径),作者要么关掉 PR,要么改实现。
因为一开始写代码就很容易,关掉 PR 并不会让人觉得是损失。关键在于在讨论串里尽早转向,而不是等到最后对一个已经定稿的 PR 提阻塞性意见。
如何落地
这套方法的大部分组件,你的团队现在就能用。
提交 pull request 之前
- 给智能体一份可运行的检查清单,把这些检查写进一个简短的 CLAUDE.md
- 设置智能体通过 hook 调用 formatter 和 linter
- 在本地跑
/code-review和/security-review,或者让一个全新上下文的子智能体来评审变更 - 创建 REVIEW.md,用它跟踪反复出现的评审问题
每个 pull request
- 强制 CI
- 在 PR 模板里加上“测试”“风险”“如何回滚”
- 先在一个仓库上接入 AI 评审者(Code Review for Claude Code,或 Claude Code GitHub Action),用几周时间迭代 REVIEW.md,再推广到更多仓库
- 加上自动化安全评审
- 要求所有评审讨论串在合并前都已解决
- 按风险施加相应强度的评审:常规变更快速过一遍,高风险区域(bug 代价高昂)做彻底评审。Code Review 提供 Quick、Standard、Deep 三档
- 限制评审轮数,几轮之后只看新的 diff
审批
- 定义风险等级,按变更而不是按作者设定。一开始从严,看到证据后再逐步放宽
- 把宽松的审批路径留给可信作者
- 机器人批准不能用来满足必需的批准。有新 commit 推送时,撤销已有批准
- 指定真人对涉及 auth、billing、CI、发布 workflow 的代码与策略,以及安装器做审批。用 CODEOWNERS 和分支保护来实现
合并与合并之后
- 搭好合并队列
- 试验功能开关
- 先向内部用户发布
- 分阶段放量
- 做一键回滚机制
- 通过记录事故和回滚,建一套 eval
- 每次改动评审者的 prompt、工具或模型,都重新给它打分
- 跟踪人的投入,把回滚率和事故率当作护栏
这件事会走向哪里
Code Review 发布时的意图是:最终批准决定仍然由人来做,产品只负责把发现贴出来。但在我们自己的仓库里,我们走得更远:owner 正在决定哪些低风险变更可以在自动检查通过后自动合并。这个边界还会继续演进。
所以每当评审者漏掉什么,我们都会问自己:模型的上下文里缺了什么?然后把它变成一个 CLAUDE.md、一个 skill,或者一项新检查。而我们的目标没有变:在保持回滚率不高于当前水平的同时,降低每次变更所需的人工投入。
如果你也允许智能体创建 pull request,欢迎告诉我们你自动化了哪些检查、哪些必须由人来做,以及我们哪里做错了。
本文是我们原文的重写,并经 Pangram 检查。