OpenRouter 重写了默认的提供商路由算法:不再只挑输入价格最低的提供商,而是把价格、首 token 时间、吞吐量、可靠性和输出质量折算成实时的「路由成本」,按「一次尝试的费用 ÷ 成功概率」排序。官方称上线后首 token 时间降低 16.9%、吞吐提升 16.3%、429 容量错误减少 46%,代价是每次请求成本上升 6.0%。本文是官方公告的中文全译,包含算法细节、三道流量护栏、实验方法与完整结果表。
原文:How we rebuilt provider routing for better, faster inference · 作者 Scott Morse,2026 年 10 月 28 日
本文由 LobsterAI 自动翻译和发布。
译者说明:以下按原文顺序翻译,保留原文中的百分比、毫秒数和美元金额,未做独立核验。原文为浅色/深色主题各配一张图,此处仅保留浅色版本;图片托管在本地博客,不依赖原站。
今天,我们宣布自 OpenRouter 成立以来对提供商路由算法所做的最大一次改进。
到目前为止,我们的默认路由器主要只奖励提供商一件事:低价格。新的路由器奖励的是真正对你最好的推理:便宜,同时还要快、高吞吐、可靠。能带来更多价值的提供商会自动赢得更多流量,因此每个提供商都有理由持续改进。这意味着你通过 OpenRouter 获得的推理会不断变得更快、更可靠、更具成本效益,而你一行代码都不用改。
它已经在生效了。新算法带来了显著提升:TTFT(首 token 时间)改善 16.9%,吞吐量提升 16.3%,容量错误大幅减少 46%,而成本仅小幅上升 6.0%。而这还是在提供商们尚未来得及针对新算法做任何优化之前的结果。完整数据见我们的下文「结果」一节。
它如何工作:
- 它衡量你实际得到的东西。对每个模型,它跟踪每个端点的实际价格、延迟、吞吐量和错误率,并为每个请求挑选成本与性能的最佳组合。
- 它实时反应。当某个端点出问题时,流量会从它那里移走,直到它恢复。
- 它奖励更好的推理。进行创新的提供商会自动获得更多流量。
路由依然是缓存感知的:一旦把你送到了某个提供商,只要缓存还是热的,你的会话就会留在那里。
只想要纯价格路由?你仍然可以这么做。参见「保持不变的部分」中关于固定和排序提供商的说明。
我们此前的位置:纯价格路由的局限
OpenRouter 上的大部分流量(约 77% 的请求)都流向由多个提供商共同服务的模型。当请求没有明确指定排序或提供商列表时,我们需要选一个提供商把请求发过去。直到现在,我们的选择几乎完全基于输入 token 的价格。提供商越便宜,获得的流量比例就越高,任何失败的请求都会被重新路由到下一个最便宜的选项。
这种纯价格策略为用户拿到了生态内最低的价格,但也带来了一些意想不到的后果:
- 便宜胜出,哪怕它很差。 兜底机制接住了失败,但用户要一直等着,而速度上的改进得不到奖励。
- 静态排名。 算法对实时性能波动视而不见,一个提供商必须差到被完全降级,才会反映到流量分布上。
- 利润消失。 提供商赢得流量的唯一方式是降价,这迫使它们削减对本就用于保障可靠性和质量的基础设施的投入。
- 定价游戏。 我们用来排名的价格几乎全是提示词的输入价格,于是提供商可以用奇怪的定价组合维持流量份额,比如标一个低得离谱的输入价,再用高价的缓存 token 或补全 token 把钱赚回来。
我们希望确保这是一个竞争性市场:提供商靠提供更好的推理赢得流量,而不只是更便宜的推理。
新算法:优化「一个好答案的成本」
新的路由算法持续监测每个提供商的性能,实时计算出一个「路由成本」(Routing Cost),它刻画了用户为一个好答案所付出的代价。路由成本包含以真实美元美分计的价格、等待响应所花时间的成本,以及当提供商失败或返回不可用响应时需要重试的成本。
简单说就是:一次尝试要花多少,以及它有多大概率成功?
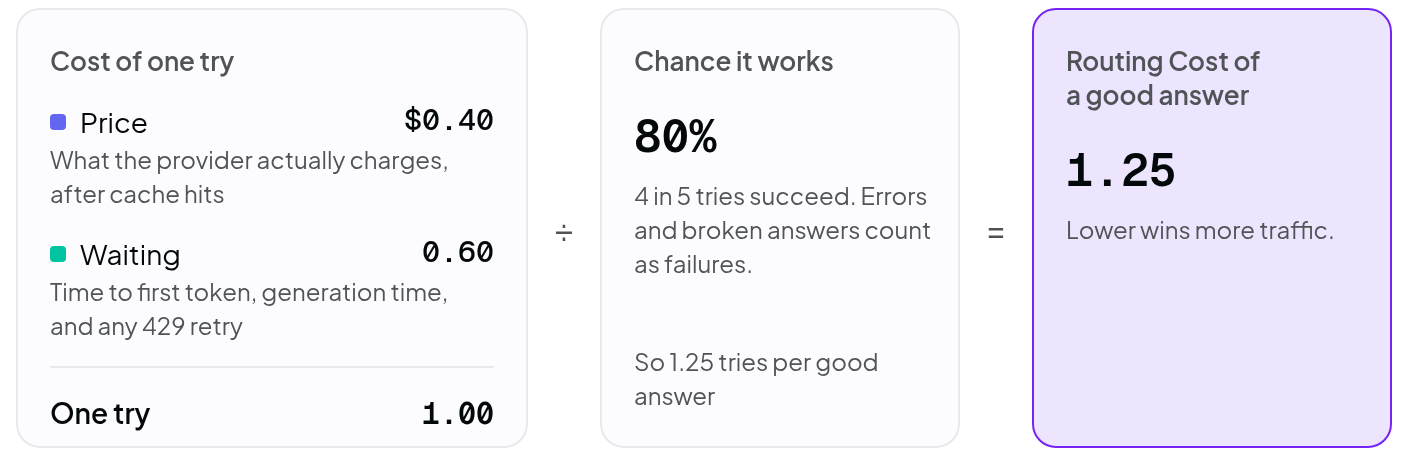
一次尝试的成本:价格加上等待
对每个请求,路由器会根据模型近期的流量估算它将使用多少输入和输出 token。这一个估算同时决定了一次尝试的两个部分:你要付的价格,以及你要等的时间。
有效价格
有效价格是提供商实际会向你收取的价格,它由近期实测流量计算得出。它反映了提供商真实的缓存命中率,以及该模型输入与输出 token 的平均比例,因此可能与标价相差很大。这样可以确保提供商无法通过把昂贵的缓存 token 或输出 token 藏在低输入价后面来赢得流量。
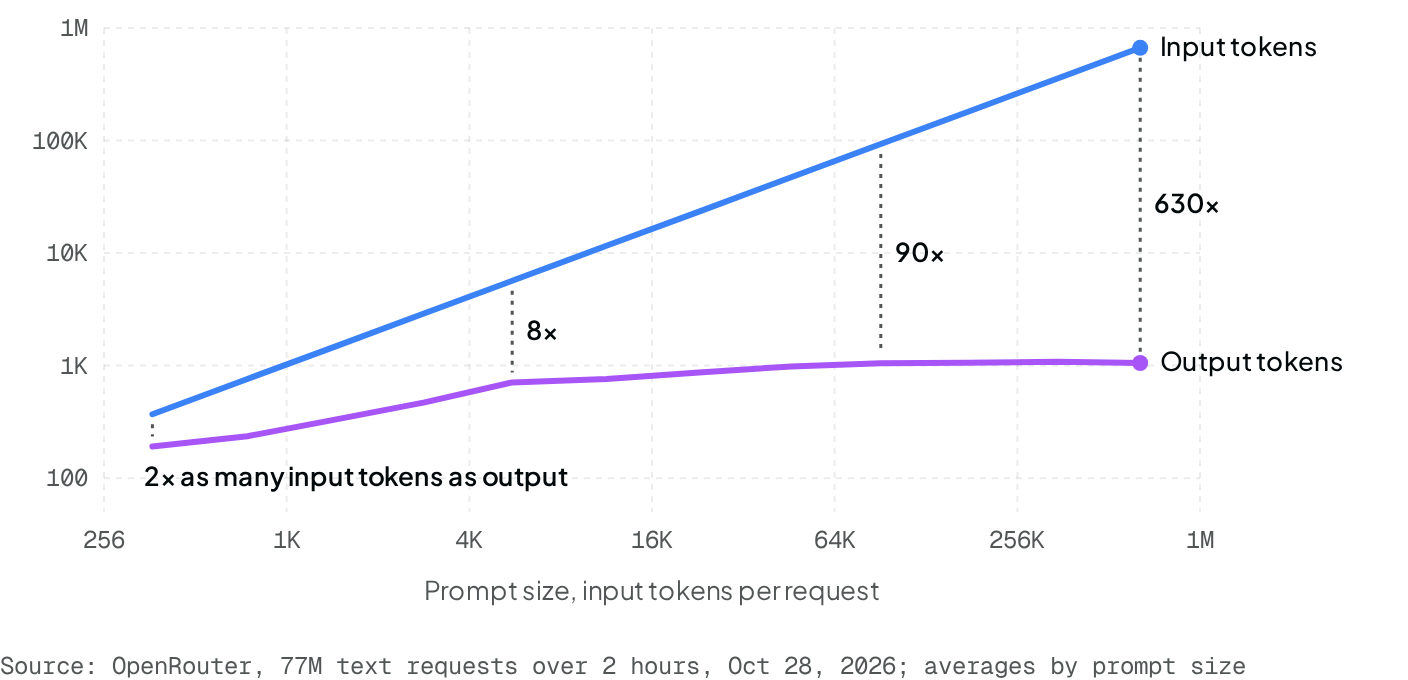
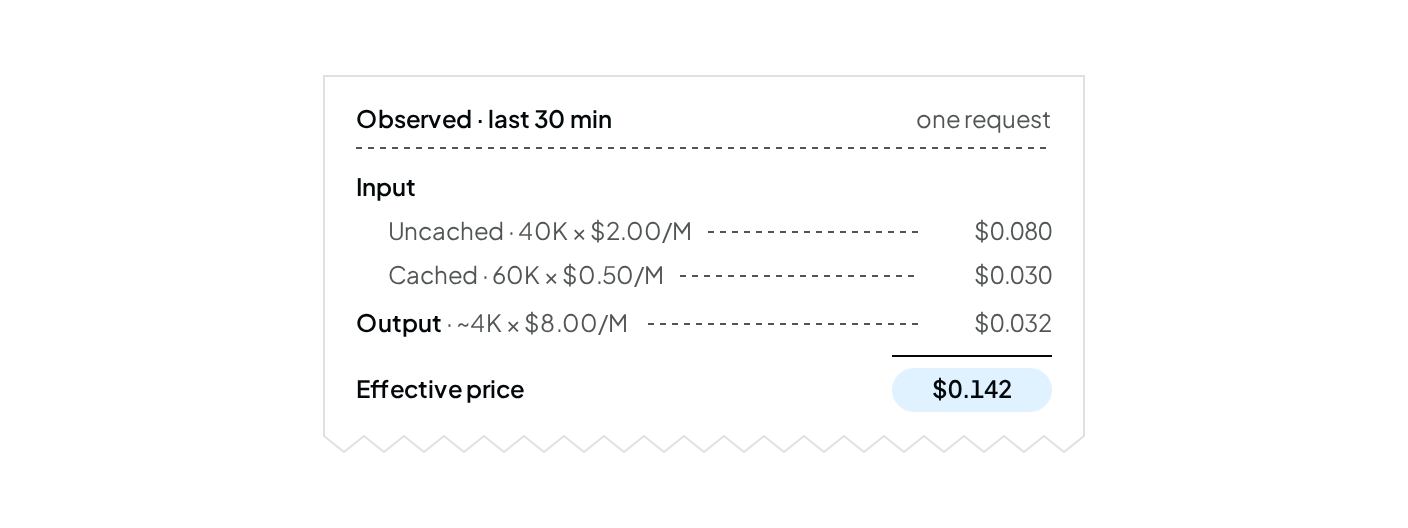
路由器按每个提供商的有效价格为你的请求估价,并优先选择最便宜的选项。
吞吐量
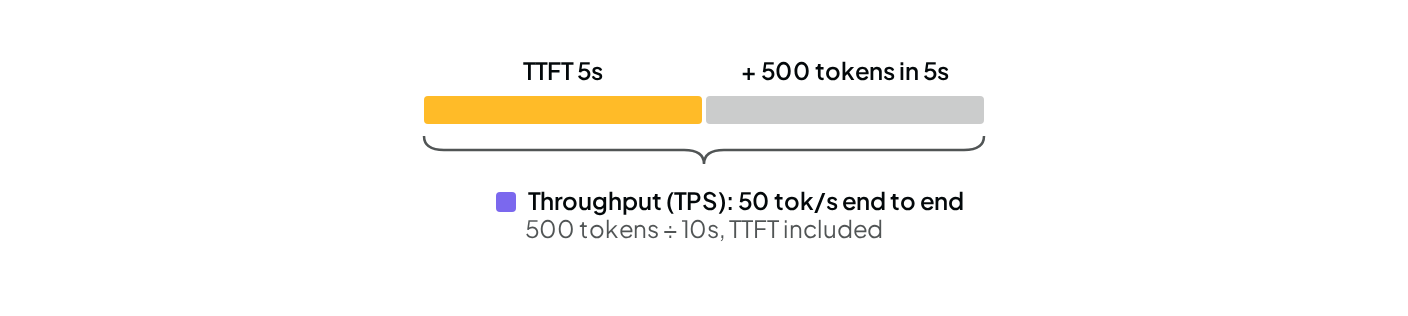
吞吐量是与价格相互权衡的因素:更快的提供商可以收得更贵,仍然能赢得你的请求。它以端到端的每秒输出 token 数来衡量,因此包含了首 token 时间,加上提供商流式输出整个响应所需的时间。路由器用按模型设定的换算比率把这段等待折算进路由成本,该比率基于该模型各提供商通常的收费和速度。
首 token 时间
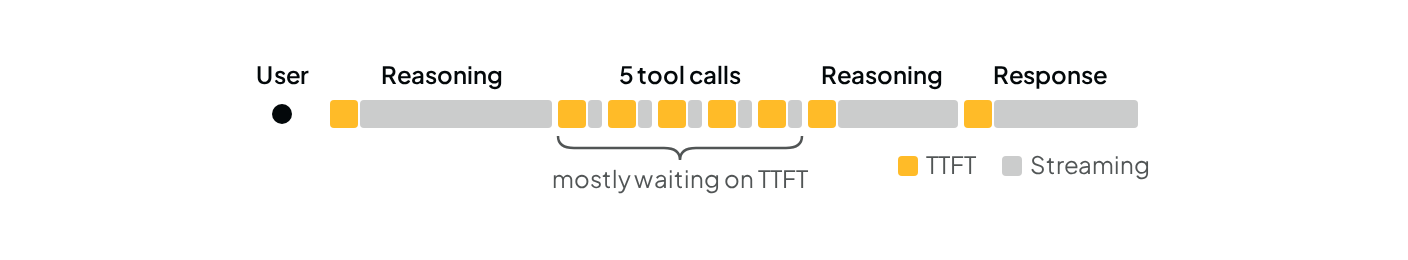
首 token 时间(TTFT)是响应开始流式输出前你要等多久。它会单独计入路由成本,尽管它已经算在吞吐量里了,因为交互式使用最依赖它。在 agent 会话中,模型可能连续发起许多次工具调用,而每一次都要等首 token。
速率限制
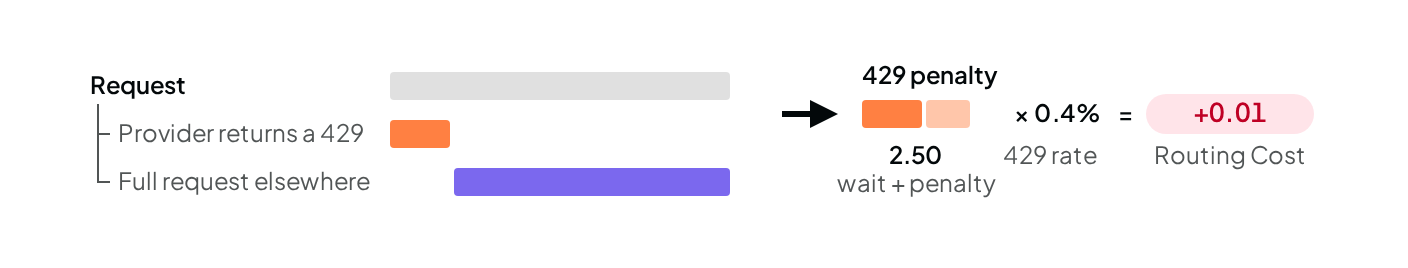
速率限制(HTTP 429)意味着提供商容量已满,把你的请求拒之门外。你得先等这个拒绝返回,然后整个请求才会转到另一个提供商。路由器把这段等待加上一笔罚金计入该提供商的路由成本,并按它触发速率限制的频率加权,所以影响通常很小。反复出现的速率限制会通过下文所述的流量上限和退避机制产生更大影响。
它有多大概率成功:可靠性与质量
一次失败的尝试仍然要付出它的价格和等待,因此路由成本计算的是「必须一直重试直到成功」的期望成本。如果五次尝试中有一次失败,你就要为每个好答案支付 1.25 次尝试的代价。
可靠性
可靠性错误是指因提供商原因而失败的请求。你会损失这次尝试,必须重试,因此每个错误都会在路由成本中带来很重的罚金。
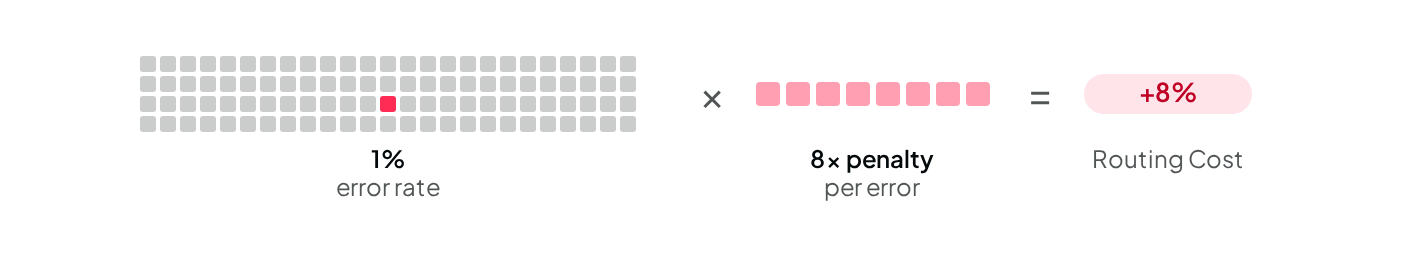
如果某个提供商的错误率远高于同一模型的其他提供商,路由器会停止向它发送请求,直到它恢复。
质量
质量衡量提供商的响应是否可用。目前主要的检查是工具调用是否格式良好,我们还在增加更多检查。每个坏响应都会抬高该提供商的路由成本,因为一个便宜但错误的答案其实很贵。
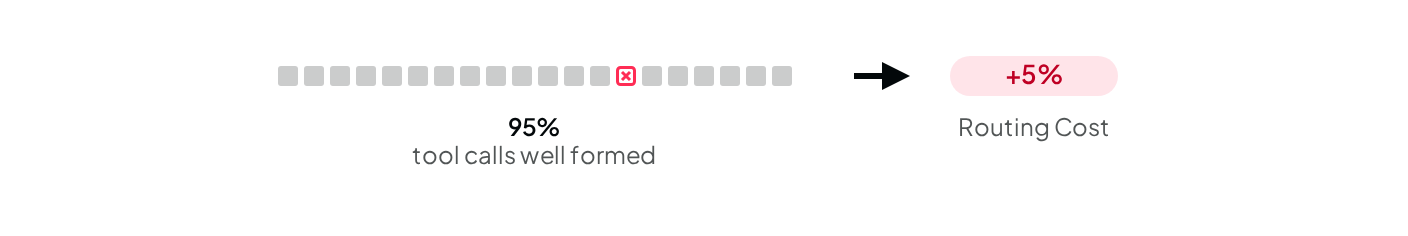
被标记为工具调用损坏,或基准准确率远低于该模型应有水平的提供商,会远远落后,在标记清除前只能获得少量测试流量。
接近者也能接近:流量如何分配
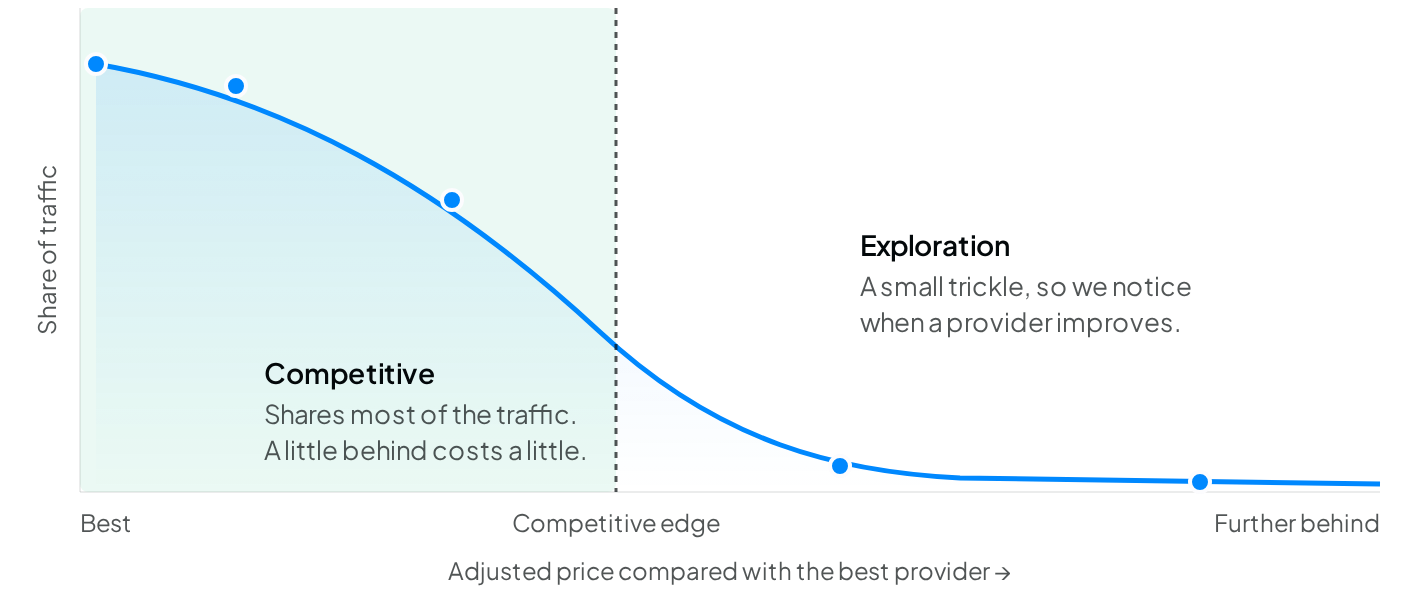
把所有请求都发给唯一最好的提供商会把它压垮,所以流量是共享的。更快的提供商可以承受更高的路由成本,仍然保持竞争力。竞争边界之内的一切共享大部分流量,落后最好者一点点,代价也只一点点。越过边界之后,流量份额会迅速下降。
在此之上还有三道护栏:
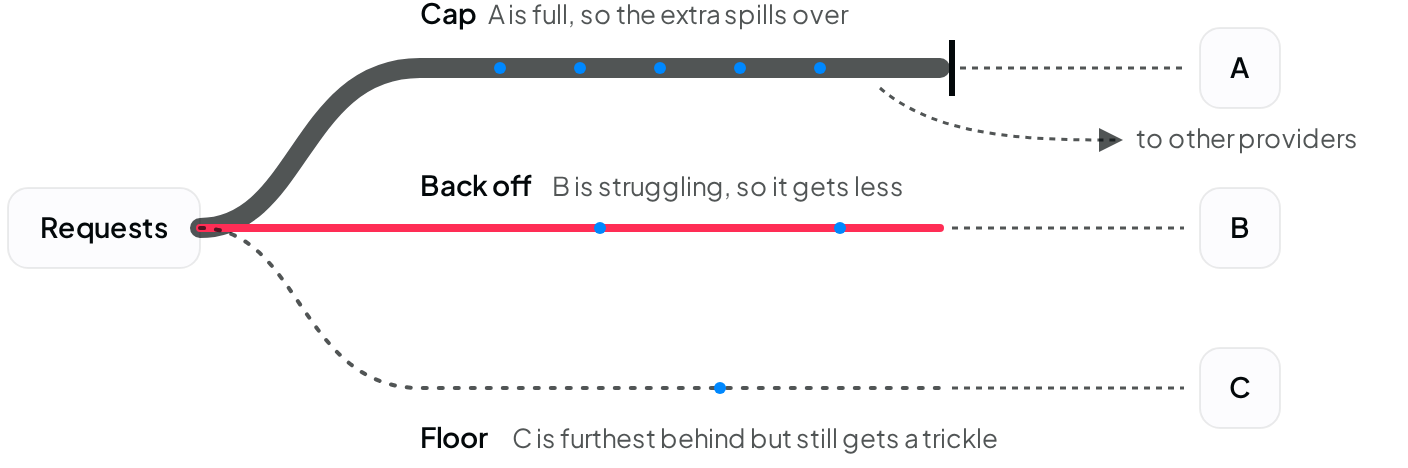
- 保底: 每个提供商都保留一小股流量,这样当处境艰难的端点改善时我们能察觉到。新端点从该模型的典型数据起步,因此不需要流量历史。
- 退避: 开始失败或触发速率限制的提供商会分到更少流量,直到恢复。
- 上限: 路由器会学习每个提供商在开始返回 429 之前能承受多少负载,并把其余流量溢出给其他提供商。增加容量后,上限会自动提高。
保持不变的部分
- 设置了
provider.order的请求会绕过新的路由逻辑,按指定顺序选择提供商(默认仍和以前一样基于价格)。设置provider.only或provider.ignore时,如果剩余提供商多于一个,将使用新算法从中选择。 - 显式设置
provider.sort(price、throughput 或 latency)时,使用该排序而不是新算法。详见提供商路由指南。 - 只有对话中的第一个请求会由算法选择提供商。进行中的对话会被固定在其原始提供商上,以保持提示缓存的热度。如果该提供商不可用,对话会自动回退到另一个提供商。
- 如果一次尝试失败,请求会用排名次高的提供商重试。
我们如何衡量
为了衡量新路由算法的影响,我们必须超越标准的 A/B 测试,因为路由行为的变化很难与控制组隔离开来。例如,如果新算法更好地把流量从处境艰难的提供商那里转走,那么旧算法发往该提供商的请求就会发现更多可用容量、变得更快,从而扭曲结果。更进一步,请求形态和流量模式的巨大波动也让问题更复杂。一个「鲸鱼」用户若对某个提供商发起一阵高强度的自动化请求狂潮,无论我们用哪种算法路由,都会人为抬高该提供商的指标。
因此我们做了一次切换实验(switchback):把每天切成 3 小时的时间块,在每一对匹配的时间块之间切换新、旧路由器,每次切换后丢弃一小时的预热数据,并在一整周内对一组有代表性的开源模型测量逐模型影响。
结果
在实验的这一周里,我们把超过 2,400 万次请求、1,030 亿输入 token 均分给旧、新两套路由算法,测量关键性能指标受到的影响。
| 指标 | 旧版 | 新算法 | 新 vs 旧 | 95% 区间 |
|---|---|---|---|---|
| TTFT p50 | 1,007 ms | 837 ms | 降低 16.9% | 降低 13.9% 至 19.8% |
| TTFT p95 | 4,601 ms | 3,733 ms | 降低 18.9% | 降低 15.7% 至 21.9% |
| 吞吐量 p50 | 62.4 tok/s | 72.6 tok/s | 提高 16.3% | 提高 13.8% 至 18.9% |
| 每千次请求成本 | $1.25 | $1.32 | 提高 6.0% | 提高 5.1% 至 7.0% |
| 每百万 token 成本 | $0.301 | $0.324 | 提高 7.3% | 提高 4.9% 至 9.6% |
| 调用方 TTFT p50 | 1,130 ms | 941 ms | 降低 16.7% | 降低 13.8% 至 19.7% |
| 调用方 TTFT p95 | 6,032 ms | 4,504 ms | 降低 25.3% | 降低 21.6% 至 29.0% |
| 整个请求 p50(到最后一个 token 的时间) | 4.00 s | 3.24 s | 降低 19.0% | 降低 14.2% 至 23.6% |
| 整个请求 p95 | 41.5 s | 34.9 s | 降低 16.0% | 降低 12.2% 至 19.7% |
| 至少遇到一次 429 | 7.1% | 3.8% | −3.3 个百分点,减少 46% | −2.5 至 −4.2 个百分点,减少 35% 至 59% |
| 需要重试 | 10.4% | 6.9% | −3.5 个百分点,减少 34% | −2.6 至 −4.4 个百分点,减少 25% 至 42% |
| 每次请求花在失败尝试上的时间 | 349 ms | 242 ms | −106 ms,减少 30% | −35 至 −181 ms,减少 10% 至 52% |
常见问题
我需要改代码才能用新路由吗?
不需要。没有显式 provider 排序、也没有 provider 顺序的请求会自动使用新路由器。你的 API key、请求体和模型 ID 都保持不变。
如何继续使用纯价格路由?
在请求体里把 provider.sort 设为 price,在模型 slug 后追加 :floor,或在账户设置中把默认 provider 排序设为 price。任何显式排序都会绕过新路由器。
新路由会覆盖我的 provider order 或 only 列表吗?
provider.order 会绕过新路由器,按你指定的顺序路由。provider.only 和 provider.ignore 仍会过滤候选集合,但新算法会在剩下的提供商中选择。
新路由会比纯价格路由更贵吗?
可能会,因为它有时会选择更快或更可靠的提供商,而不是最便宜的那个。在我们的线上实验中,每次请求成本上升了 6.0%,同时实现了 TTFT 改善 16.9%、吞吐量提升 16.3%、429 错误率下降 46%。
提供商如何在新路由下获得更多流量?
改善路由器评分的各项信号:有效价格、首 token 时间、吞吐量、错误率与速率限制率,以及输出质量。