决策模型正扎堆涌现,被当作 LLM 裁判的低成本替代品。但它们的分数能不能直接用?本文用 100 条公寓租赁代理的真实 trace,实测 Jev、Perplexity Decider、Liquid d1、Cloudflare Clef 和 OpenAI Decisions:先用分层交叉验证把每个模型的决策阈值调到最佳,再在 F1 与成本之间找帕累托前沿,最后检查这些概率是否配得上“置信度”这三个字——并附上两段可以直接丢给编码智能体的调参提示词。
原文:How to Use Decision Models for Evals,作者:Hamel Husain(@HamelHusain),与 Antaripa Saha 合著,发布于 2026 年 10 月 21 日。
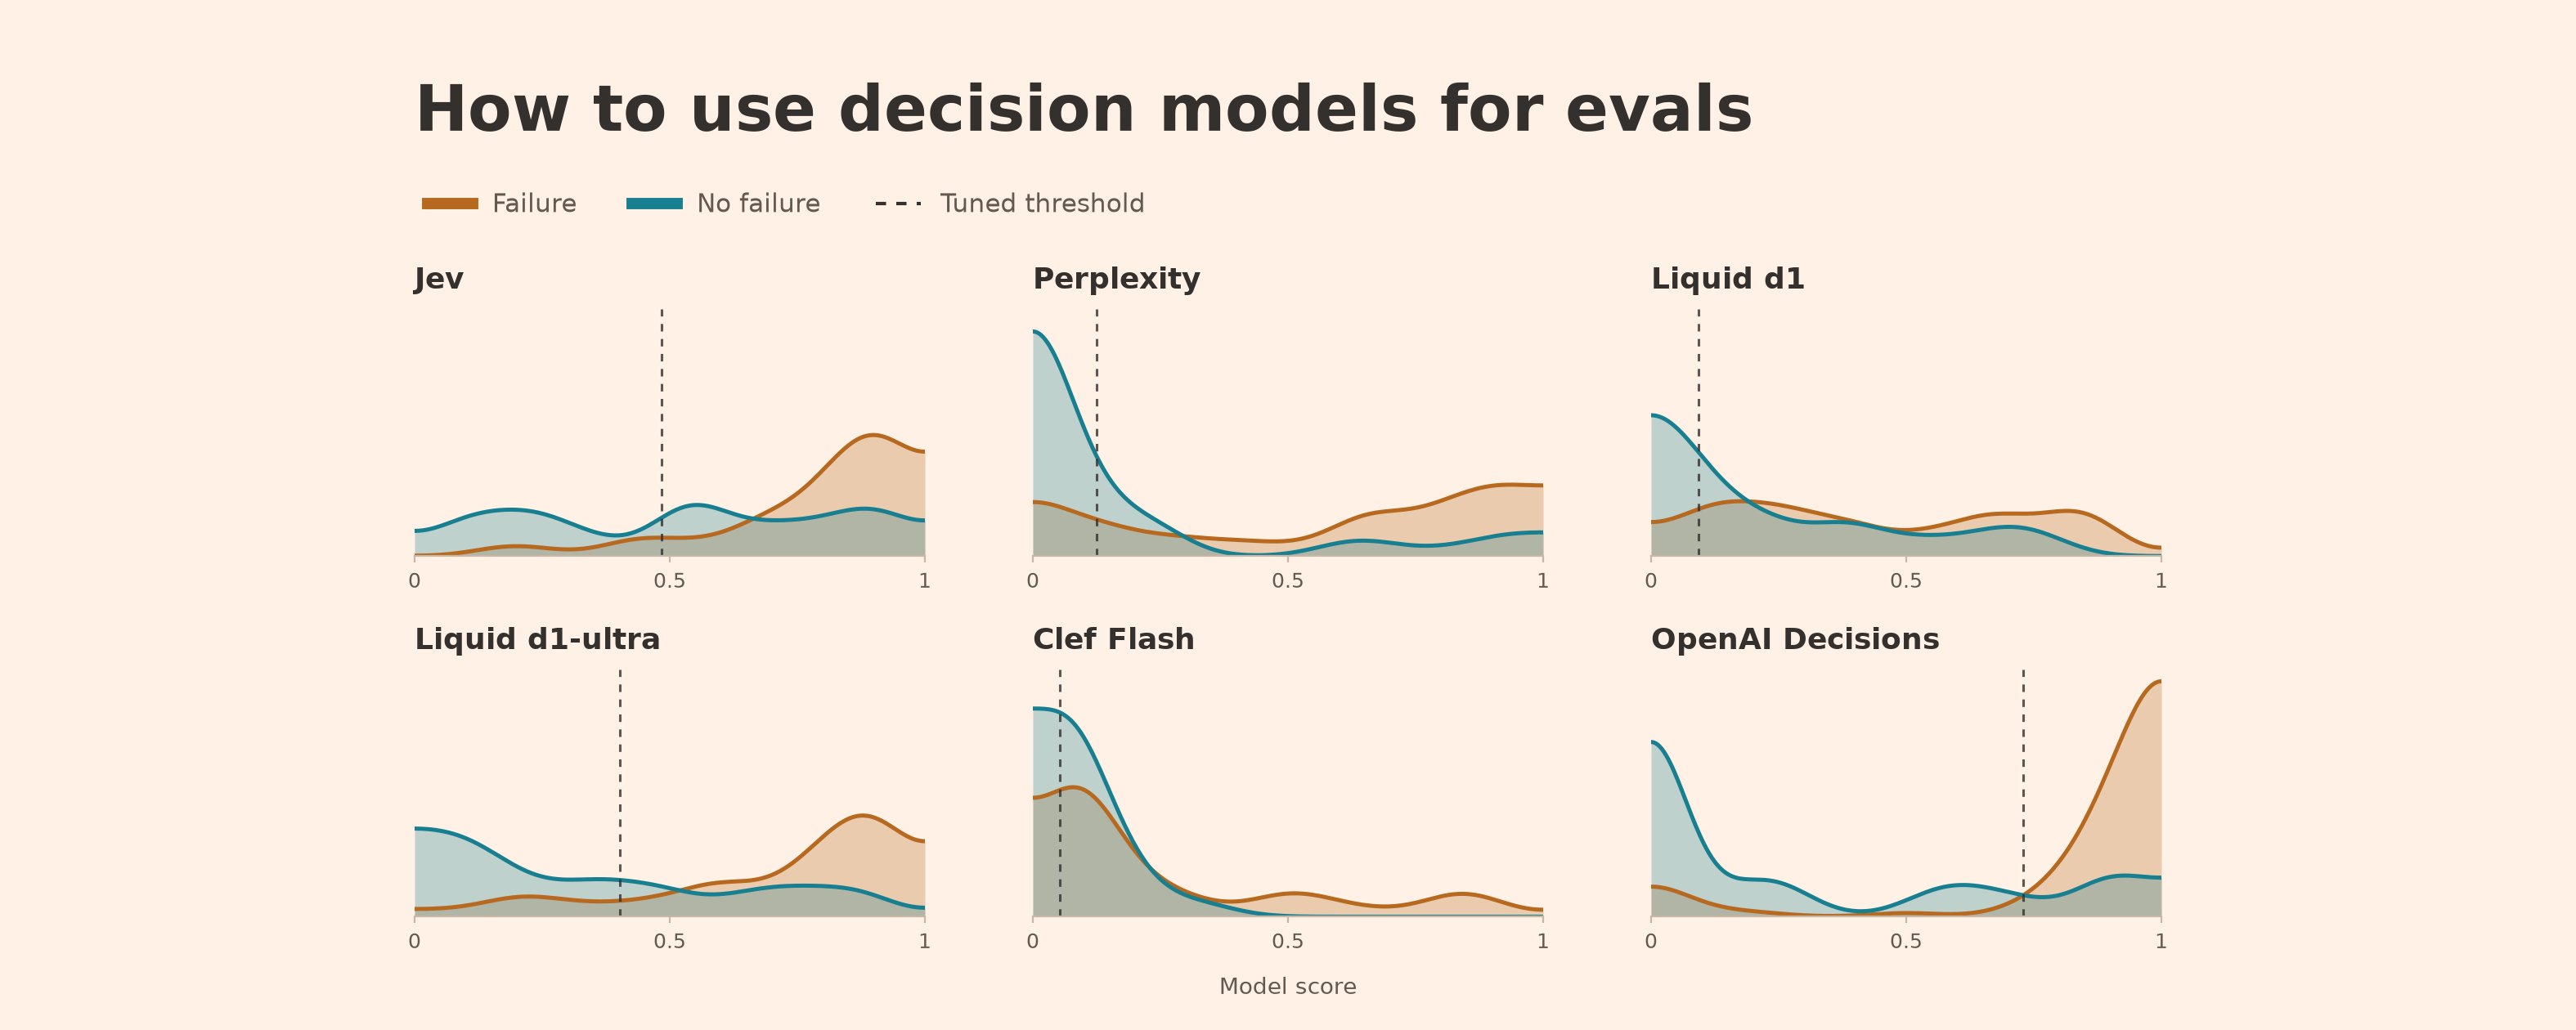
决策模型最近扎堆涌现:从 TypeSafe 的 Jev 开始,接着是 Perplexity 的 Decider、Liquid 的 d1、Cloudflare 的 Clef,以及 OpenAI 的 Decisions API。这些模型承诺提供快速、廉价的分类能力。
在自动化评估中,决策模型是 LLM 裁判(LLM judge)之外一个颇具吸引力的低成本替代方案。但它们是否适合你,取决于你的用例对成本、性能和延迟的要求。
我们还注意到,很多人直接使用 0.50 的默认决策阈值,却不检查它是否适合自己的任务。这会白白丢掉大量性能。
本文先演示如何调整阈值,让决策模型发挥出最佳效果。在阈值调好之后,我们会比较成本与性能,帮你判断哪个模型适合你的用例。最后,我们会探讨在决定是否采取行动时如何解读模型分数,以及校准(calibration)如何让这些分数更适合当作置信度估计。
下面的图表是静态预览。为了最佳的阅读体验,我建议在 hamel.dev 上阅读本文,那里可以交互式探索图表。
我们测试了什么
我们使用了 100 条 trace(对话与操作的日志),来自一个公寓租赁代理。任务是找出包含错误的 trace,例如预订失败,或漏掉了转人工。我们在此前那篇关于自动化评估的文章中使用了相同的数据集和这个宽泛的故障发现任务。在这里,每个决策模型会为每条 trace 返回一个失败概率。
我们测试了 Jev 1.13、Perplexity Decider 1.1 27B、Liquid d1 与 d1-ultra、Cloudflare Clef Flash,以及 OpenAI Decisions(GPT-6 Luna)。每个模型都收到相同的评估标准。附录给出了提示词,以及 Jev 所用的结构化版本。
我们从两个维度比较模型:
性能:将每个模型的预测与人工审阅并标注为通过或失败的 trace 进行比较。这衡量的是模型在抓住故障的同时避免误报的能力。
成本:我们根据 token 用量和厂商价格计算 API 成本。
为简洁起见,我们暂不讨论延迟,因为它取决于本实验无法控制的因素。
理解决策阈值
我们给每条 trace 打上两个标签之一:通过或失败。这就是二分类的通过/失败评估,我们推荐这种形式,因为它促使评估标准清晰,也更容易与人类偏好对齐。
每个决策模型返回一个 0 到 1 的分数,用来估计一条 trace 包含故障的可能性。API 会用 0.50 的默认决策阈值把这个分数转成决策:分数大于等于阈值的 trace 被标记为失败。不结合自己的数据验证就直接用这个默认值,结果可能不理想。
例如,某个模型可能给每个失败样本打 0.40 分,给每个通过样本打 0.10 分。这个模型在 0.30 的阈值下能完美分类,但用默认的 0.50 阈值则一个都抓不到。
实践中,失败样本和通过样本的分数会重叠。降低阈值能抓到更多失败,但也会带来更多误报。选择阈值就是在以下两者间权衡:
精确率(Precision):被标记的 trace 中确实包含已知故障的比例。
召回率(Recall):模型抓到的已知故障所占的比例。
正确的权衡取决于你的业务目标。例如,刑事审判对定罪设定了很高的门槛,以避免给无辜者定罪,因此强调精确率。癌症筛查可能更强调召回率,宁可接受更多误报,也要少漏掉病例。在本次比较中,我们用 F1 分数(两者的调和平均)给精确率和召回率相同的权重。F1 取值为 0 到 1,越高越好。
下面的曲线展示了每个模型给失败样本(橙色)和通过样本(蓝色)打分的分布。曲线越高,说明该类中落入该分数区间的样本越多。分数达到或超过虚线阈值即被标记。可用切换开关在 0.50 和“为最佳 F1 优化”之间比较,后者会为每个模型选择阈值。
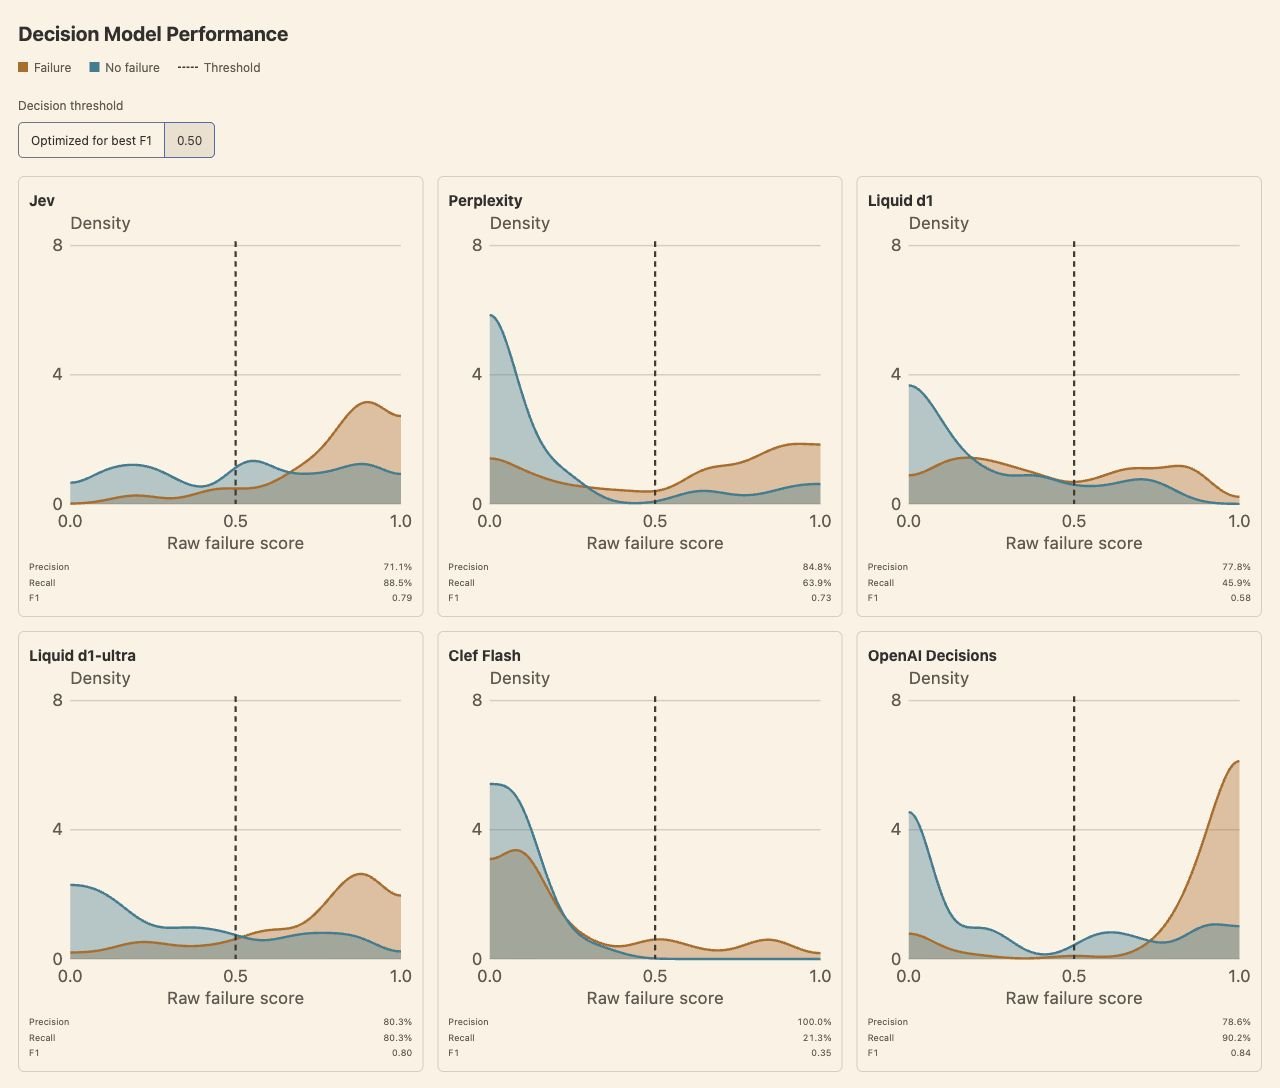
在这项任务上,OpenAI 对两类的区分最好,这也体现在它更高的 F1 分数上。
同样重要的是,不要在不考虑分类器可用性最低要求的情况下盲目最大化 F1。例如,如果这个分类器用于自动告警系统,我会要求精确率和召回率都不低于 80%,这样既能尽量减少误报,又能抓到足够多的故障。
下图展示了精确率和召回率随阈值变化的情况。阴影区域标出了两者都至少达到 80% 的范围。
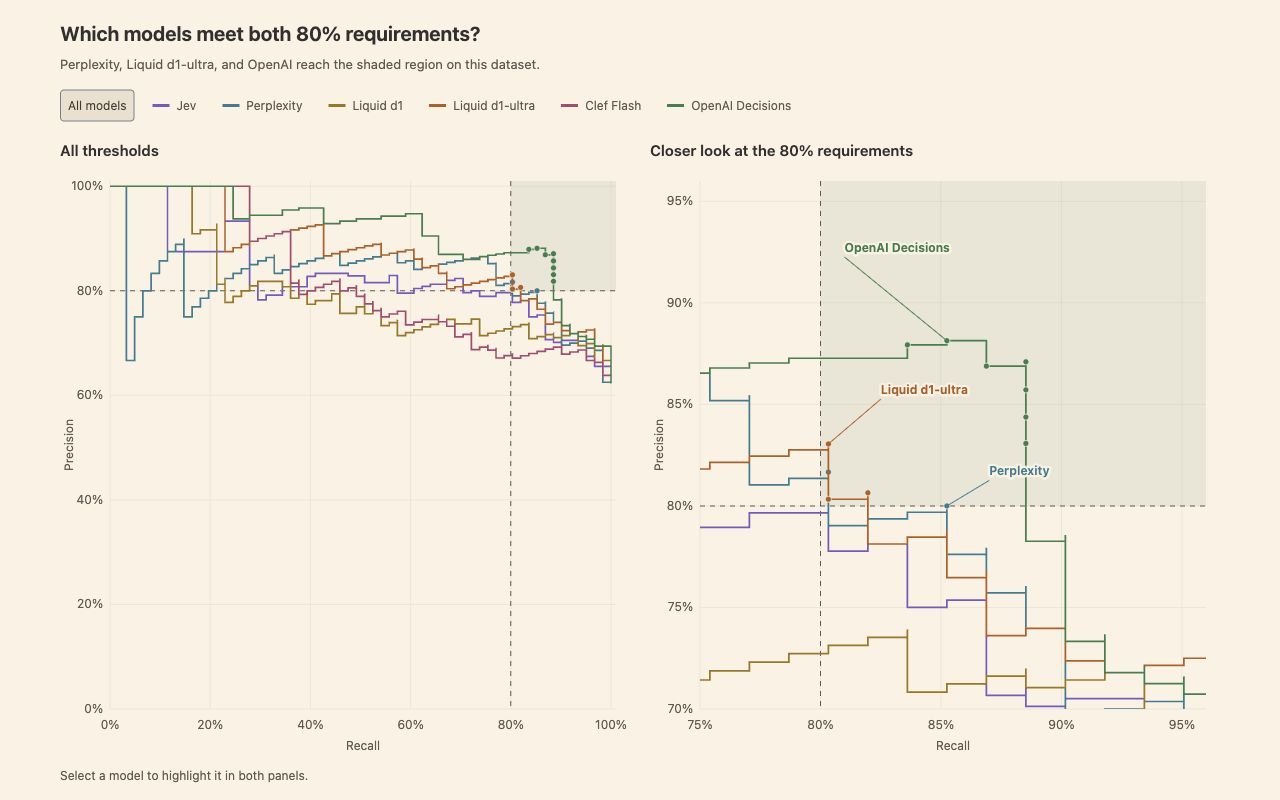
Perplexity、Liquid d1-ultra 和 OpenAI Decisions 满足我们的要求,但我们仍需在阴影区域内为每个模型选定一个决策阈值。下一节会讨论如何调这些阈值。
调整决策阈值
在这个例子中,我们优化 F1。对候选模型,我们会尽量把调参限制在训练数据上同时满足两个 80% 下限的阈值范围内。其他模型不加约束,以便展示调参的效果。
有了带标签的 trace 和保存下来的模型分数,你可以让编码智能体来调阈值。下面是一个示例提示词,你可以按自己的用例修改:
用我保存的模型分数和二分类标签(1 表示失败),调出一个使 F1 最大化的决策阈值,同时要求精确率至少 80%、召回率至少 80%。使用分层五折交叉验证,在训练样本上选择阈值,在剩余样本上衡量性能。如果比较多个模型,每个模型使用相同的划分。只选择在训练样本上同时满足两个下限的阈值。如果没有阈值合格,报告这一情况,而不要放宽任何一项要求。报告验证集上的精确率、召回率和 F1,以及任何没有阈值合格的划分或验证性能低于我设定下限的划分。与默认阈值 0.50 进行比较。复用已保存的分数,不要发起新的模型调用。
下图展示了为 F1 调参如何改变每个模型的表现。我们把精确率-召回率图中那三个候选模型放在一起,其余模型以灰色显示,以说明调参能带来多大帮助。
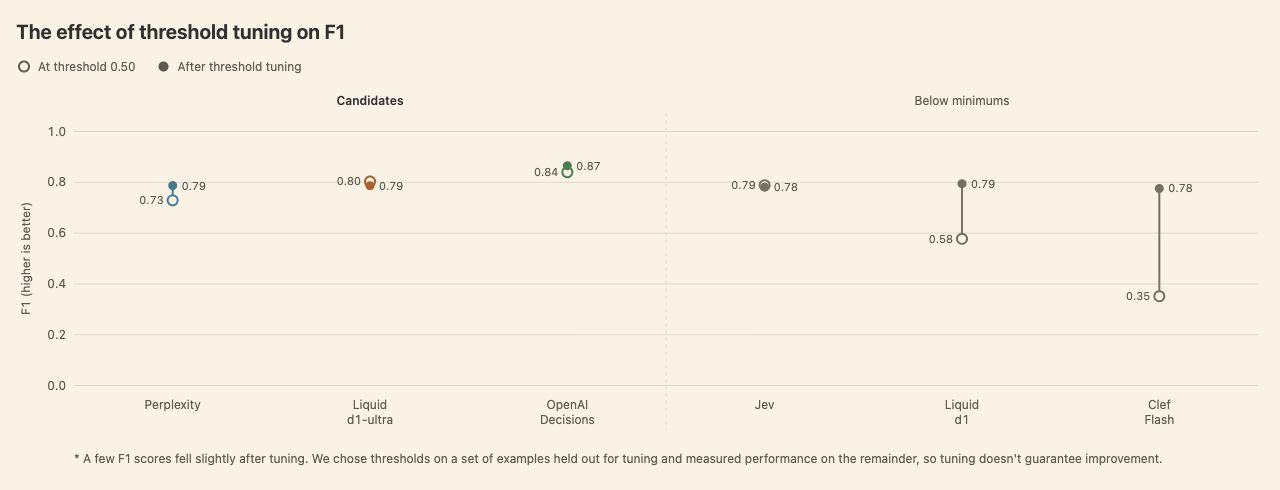
我们的候选模型从 F1 调参中获得的提升,不如 Liquid d1 和 Clef Flash 那么大,而这两个模型没能达到我们的下限。不过,精确率和召回率的微小变化也可能影响业务成本或用户体验,所以要有意识地选择权衡方式。实践中,精确率和召回率不太可能同等重要(本文用 F1 时作了这个假设)。例如,F-beta 分数允许你在 beta 小于 1 时给精确率更高权重,在 beta 大于 1 时给召回率更高权重。优化不同的指标,可能得到不同的阈值和结果。
性能与成本
下图比较了各模型(调参后)的 F1 与成本,只聚焦我们剩下的候选模型:
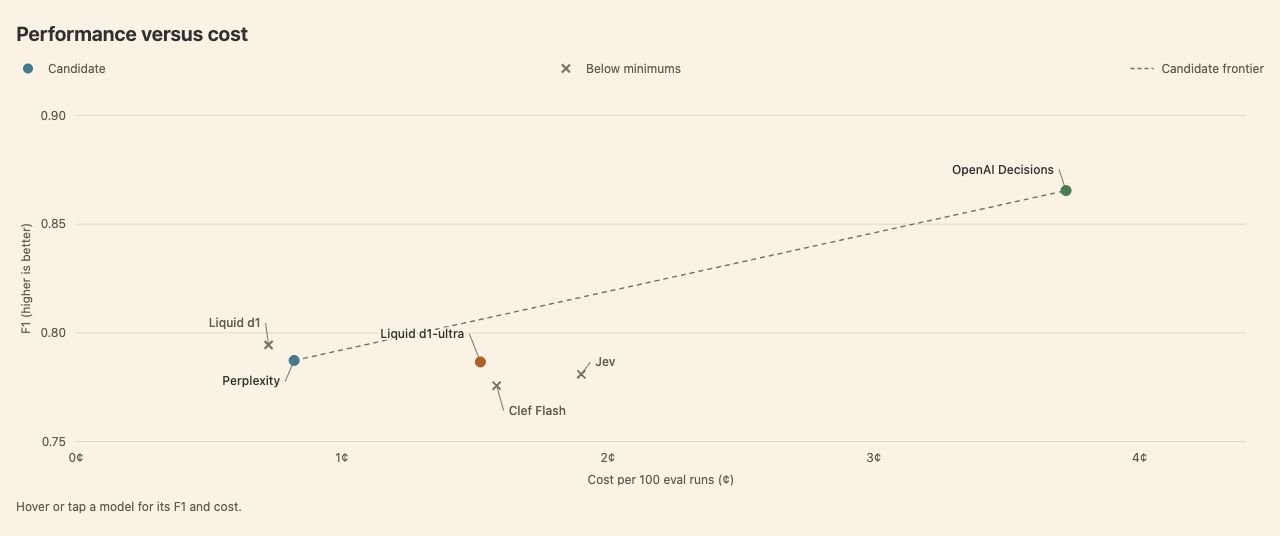
虚线表示剩余候选模型之间的帕累托前沿。对任意给定的 F1 分数,它标出能达到或超过该分数的最便宜候选模型。这张图只有三个选项,略显单薄,但很好地说明了该如何思考成本与性能的关系。
在这些候选中,Perplexity 最便宜:每 100 次评估运行 0.82 美分,F1 为 0.79。OpenAI Decisions 的 F1 达到 0.87,每 100 次评估运行 3.72 美分,成本约为前者的 4.5 倍。
我们能相信这些概率吗?
除了通过/失败评估,你可能还想把决策模型的分数当作置信度估计。但这个数字能照字面理解吗?要让 0.80 的分数表示 80% 的失败概率,那么分数相近的 trace 中应当约有 80% 确实包含失败。
下图展示了各模型概率的校准情况:预测概率与观测结果的吻合程度。每个点代表约 20 条分数相近的 trace。点落在对角线上,表示预测概率与该组的失败率一致。点在线上方,说明模型低估了失败风险;在线下方,说明模型高估了风险。
如果预测概率与观测结果不符,我们可以用另一个模型来校正。右侧面板展示了一种方法——Platt 缩放(Platt scaling),它拟合一条简单曲线来完成校正。
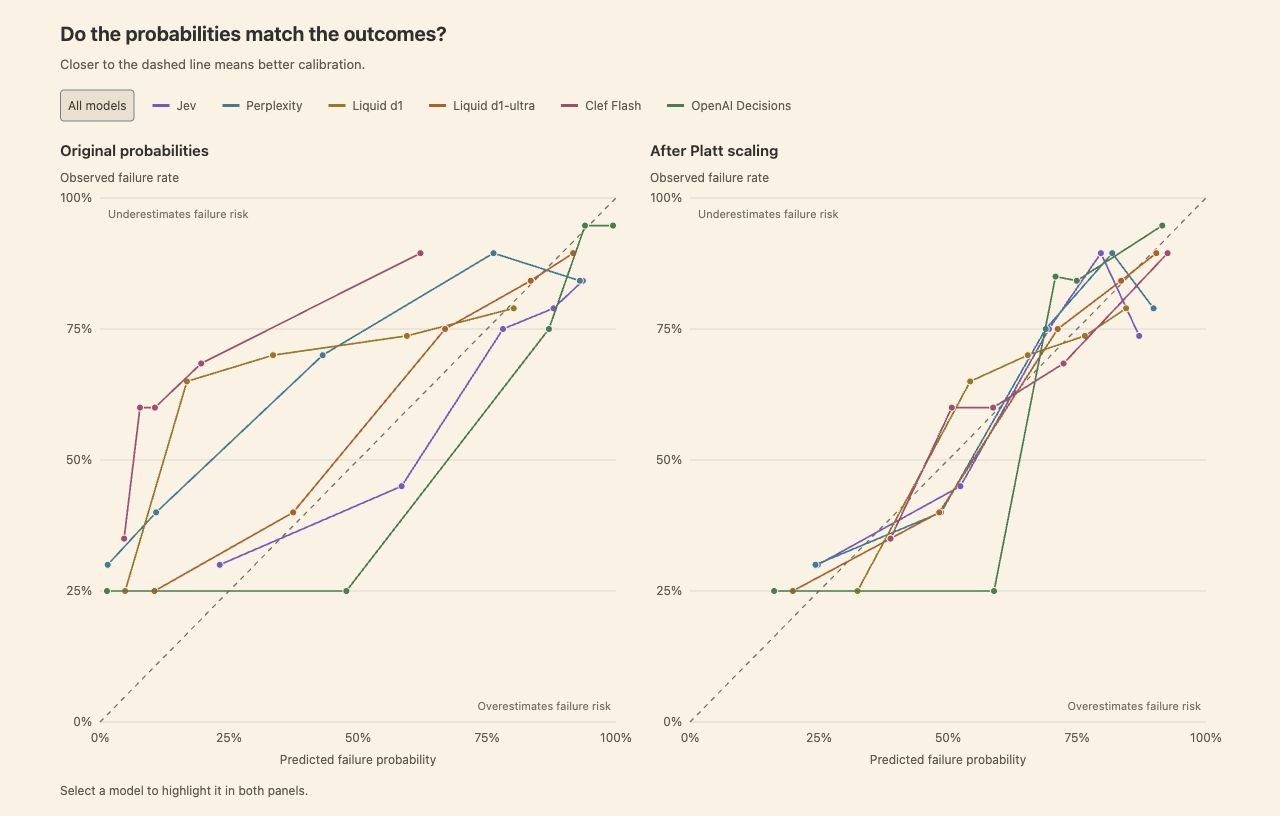
校准后,Perplexity、Liquid d1 和 Clef Flash 更接近对角线。例如,Clef Flash 有一组 trace 的平均预测失败概率约为 8%,但其中 60% 确实包含失败。
Jev 和 Liquid d1-ultra 在这个数据集上本来校准得就很好,几乎不需要调整。
Platt 缩放并非总是最佳选择。例如,我们使用的这个版本的 Platt 缩放让 OpenAI 的概率反而略差。你可以用下面的提示词让编码智能体执行校准:
用我保存的失败概率和二分类标签(1 表示失败),检验 Platt 缩放能否改善每个模型的概率。使用分层五折交叉验证,每个模型使用相同的划分。在每个训练折上拟合校准映射,并应用到剩余的 trace 上。在对数几率(log-odds)空间上拟合,先对概率做截断,避免取到 0 和 1。绘制校准前后的预测概率与观测失败率对比图。报告 Brier 分数(越低越好),并说明哪些模型变好、哪些变差。复用已保存的分数,不要发起新的模型调用。
提示词调优与评估器范围
本文刻意把评估任务定得比较宽泛,以便更容易看出模型之间的差异。实践中,我们建议针对每一种失败模式单独构建一个裁判。任务更窄、指引更具体时,我们预计模型之间的性能差距会缩小。
我喜欢先从一个在该任务上表现可接受的大模型开始,再尝试更小的模型,看它们能否以更低的成本达到大模型的性能。如果你有高质量的标签,提示词调优也会有帮助。我在另一篇文章中讨论了如何设计好的裁判提示词。
把这些想法付诸实践
在这个特定数据集上,OpenAI 以更高的成本换来了突出的性能。Perplexity 和 Liquid d1-ultra 提供成本更低、性能也更低的选项。我们观察到,模型性能在不同任务和数据集之间差异很大,因此自己动手测量非常重要。
总结一下:
- 当你对裁判提示词满意后,为你的用例设定精确率和召回率的最低要求,并排除达不到要求的模型。
- 在比较性能之前,先调好每个模型的决策阈值。选择符合业务目标的精确率-召回率权衡。要有意识,别因为本文用了 F1 就照抄 F1!
- 如果你想把分数当作置信度估计,先检查概率是否与观测结果相符。校准可能有帮助,但你需要测量它是否真的改善了概率。
- 针对你的工作负载,在性能、成本和延迟之间权衡。
这个过程是迭代的。你改进了提示词,可能就需要重新调阈值,或重新审视校准。本文聚焦阈值调优和校准,是因为我们看到很多人直接开箱使用决策模型,完全不考虑这些因素。
你可能还想知道决策模型与 LLM 相比如何。OpenAI Decisions 底层用的是 GPT-6 Luna,它以最高成本带来了我们这里最高的 F1,这说明更难的评估任务可能值得为 LLM 多付钱。在更广泛的比较中,Randy Olson 发现,决策模型能在分类和路由任务上以更低成本媲美 LLM,而在需要知识和推理的任务上 LLM 更胜一筹。
本文讨论的观点都不新鲜。选择精确率-召回率权衡、调阈值、比较性能与成本,本就是评估任何分类器的一部分。想深入了解这些基础,我推荐 Kyle Gallatin 和 Chris Albon 的《Machine Learning with Python Cookbook》第 2 版。
最后,如果你是一名数据科学家或 ML 工程师,正在疑惑自己在 AI 时代该处于什么位置——这些技能你本来就有。是时候“复仇”了 🙂
附言:我会在邮件通讯中分享这类文章,以及我在构建 AI 产品过程中的所学。想深入了解评估,可以看我和 Shreya Shankar 合著、由 O’Reilly 出版的《AI Evals for AI Engineers》。
又附:本文有很多脚注,可在 hamel.dev 上阅读。
本文由 LobsterAI 自动翻译和发布。