本文是 MIT CSAIL 博客文章《Sparks of Weight-Space Programming》的简体中文全译。作者发现,前沿 LLM 已经能原生读写神经网络权重:仅凭原始权重判断网络训练任务、一次性编辑 3.5% 权重修好卡在坡道上的小车、零样本写出击败 PPO 的游戏网络,并在 Qwen3.5-0.8B 上只改 0.016% 权重就把 MATH-500 从 7.9% 提升到 48.1%。作者把这种能力称为「权重空间编程」,并讨论了它对可解释性、优化与模型审计的意义。
原文:Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights · MIT CSAIL,2026 年 11 月 2 日
本文由 LobsterAI 自动翻译和发布。
Rikiya Takehi*、Jayden Teoh*、Alex Zhang、Omar Khattab(* 共同一作)|MIT CSAIL|2026 年 11 月 2 日
TL;DR
我们发现,前沿 LLM 在原生读写神经网络权重方面出奇地擅长,远远超出我们对人类或传统算法的预期。这对优化和可解释性都可能意义重大。
仅凭查看原始权重,GPT-6 Astra 就能判断出一个网络被训练来做什么。而且,在没有任何环境反馈的情况下,它也能从零写出小型游戏策略网络,其表现超过了用 PPO 训练 1 亿步的网络。
同样地,在被要求不用梯度让 Qwen3.5-0.8B 更擅长数学时,Astra 识别出了其权重中导致推理循环的问题——Qwen 自己的模型卡也警告过这一点——并通过原生编辑 0.016% 的权重修复了它。在相同采样设置下,这一权重修正把 MATH-500 从 7.9% 提升到 48.1%,并且开箱即用地泛化到指令遵循,把 IFEval 提升到 3 倍。
这一切都不需要让 Astra 编写训练循环。它用自己的推理弄清楚神经网络每一部分计算什么、或者应该计算什么,然后相应地修改权重。我们称之为权重空间编程(Weight-Space Programming)。
在深度学习的历史中,我们一直把朴素的归纳偏置编码进 Adam 或 Muon 这样的小型符号优化器。这种情况正在改变:我们的神经网络权重,很快将由那些会刻意对自己的权重进行推理的 LLM 来原生优化。
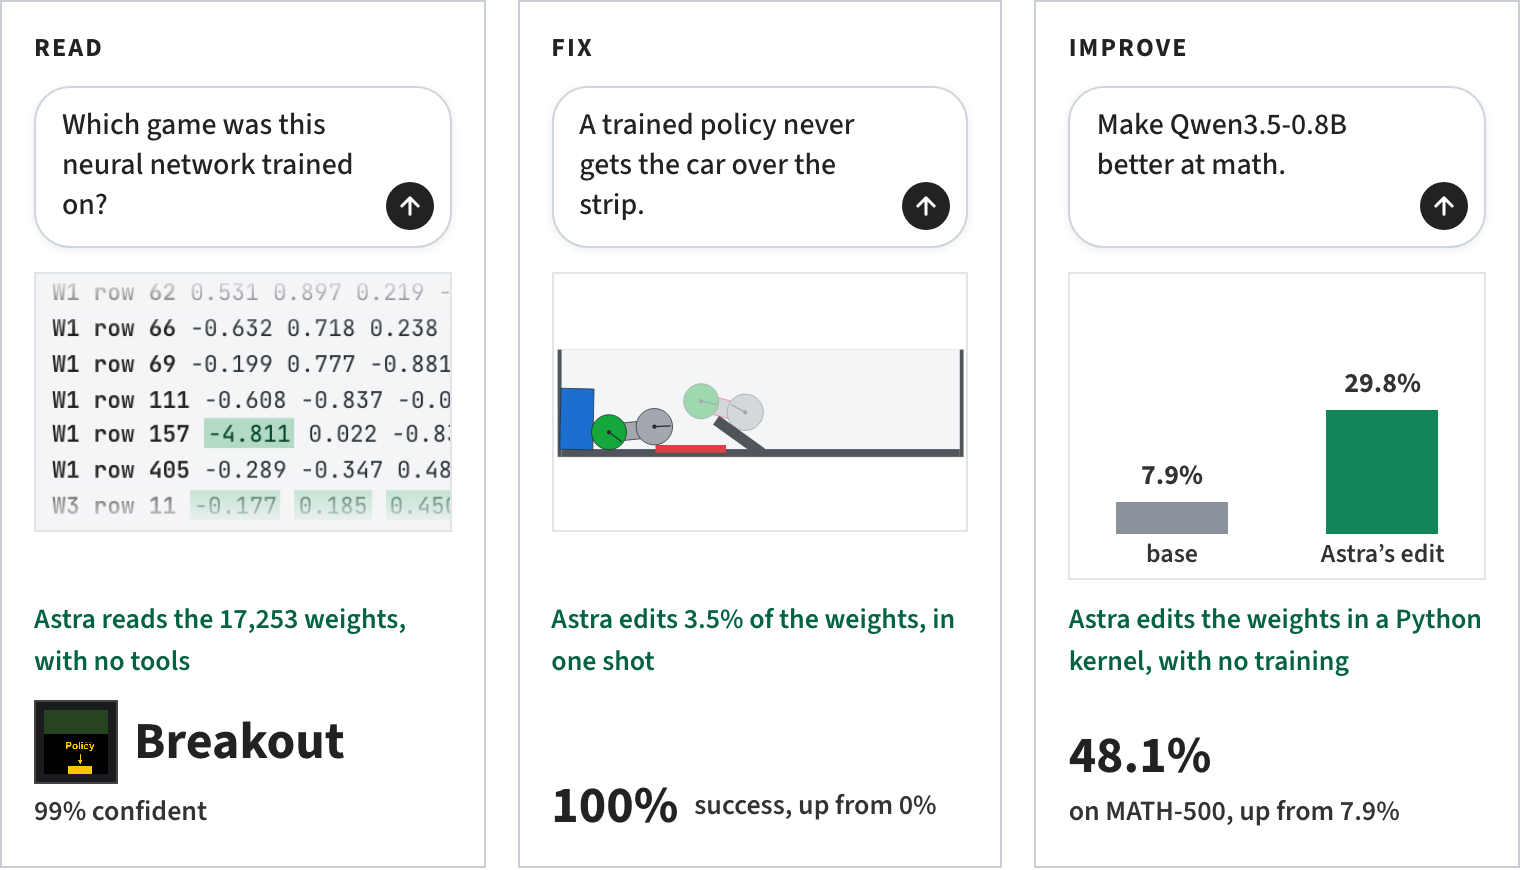
原文首图。 读:这个神经网络是在哪个游戏上训练的?Astra 不使用工具,直接阅读 17,253 个权重,答出 Breakout(99% 置信)。修:一个训练好的策略始终无法让小车越过条带;Astra 一次性编辑 3.5% 的权重,成功率从 0% 提升到 100%。改:让 Qwen3.5-0.8B 更擅长数学;Astra 在 Python 内核中编辑权重、不做训练,MATH-500 从 7.9% 提升到 48.1%。
如果让你手工打造一个会下围棋的神经网络,你会怎么做?如果直接把原始权重交给你、让你预测它的行为,你又会从哪里下手?对几乎任何人类来说,这实际上都是不可能完成的。
今天,权重是由优化写出来的,是由专门训练来写权重的定制网络写出来的,或者是由从形式化程序编译出来的。在这篇文章中,我们发现:当前这一代前沿 LLM,在原生使用自然语言的情况下,正开始以一种令人不安的出色程度,围绕自然语言目标来理解和构造神经网络权重。
权重空间编程
过去几年,我们一直在用 LLM 优化文本产物,比如提示词以及围绕它们构建的程序。更近一些,我们开始用它们优化整套 harness,以及训练 ML 模型的训练代码和超参数。
我们常常这样为这些方法辩护:除了文本产物,我们不知道还有别的更有原则的方式来做爬山式搜索——而对于可微神经网络的权重更新,情况就不同了。毕竟,人类可以手工“优化”代码,所以让 LLM 来做这件事是合理的;但人类无法手工“优化”神经权重,所以这些权重在很大程度上仍属于符号算法的领域。
在这篇文章中,我们分享一些非常早期的结果,它们让我们得以主张:由推理驱动的优化范式,如今连可微神经网络也要被纳入进来了。
在权重空间编程中,一个通用 LLM 围绕某种自然语言规格,直接读写网络的权重(也就是说,不通过优化器,尤其不通过梯度下降),有时甚至完全没有环境反馈。
用自然语言,已经变得可以“直接要求”LLM 原生地找出神经网络权重中的某个隐藏特征或故障、修复该故障,或者从零写出一个新网络。下面我们报告这三方面的早期、令人兴奋的结果,先从小网络开始,然后甚至扩展到真实的语言模型:
- **LLM 能读神经网络权重:**在实验 1 到 3 中,我们问 Astra 一些问题,比如一个网络被训练来玩什么游戏、一个扩散模型画出什么形状、一个小语言模型是在哪种语言上训练的。在实验 7 中,我们问两个语言模型中哪一个被训练成了谄媚型。
- **LLM 能修神经网络权重:**在实验 4 中,我们让 Astra 修复一个在某个物理控制任务上失败的网络。在实验 8 中,我们让它让 Qwen3.5-0.8B 更擅长数学,而它的修复也同时改善了指令遵循。
- **LLM 能从零写神经网络权重:**在实验 5 中,我们让 Astra 给出玩三个 MinAtar 游戏的网络;在实验 6 中,给出一个下围棋的网络。
LLM 能仅凭权重理解模型行为吗?
我们从一个较小规模的实验开始,看看 LLM 是否能理解连续的权重空间——它本质上只是一串数字。
在最初的几个实验中,我们用某种算法训练一些神经网络。如果 LLM 仅凭权重就能说出它的行为,那将极其令人兴奋。
实验 1
仅凭权重,Astra 能说出网络是在哪个游戏上训练的吗?
我们用 PPO 训练神经网络策略来玩四个电脑游戏。四个网络接收相同的输入通道、从相同的动作中选择,而且网络维度完全相同,因此除非阅读权重,否则无法分辨它们。
对每个网络,我们把它原始权重作为提示词传给 Astra,并问:这个神经网络是在哪个游戏上训练的?**即使没有告诉它我们考虑了哪些游戏选项,Astra 仍然能为四个网络全部说出正确的游戏。**这尤其令人兴奋,因为外面的游戏如此之多,Astra 本可以选择任何一个。
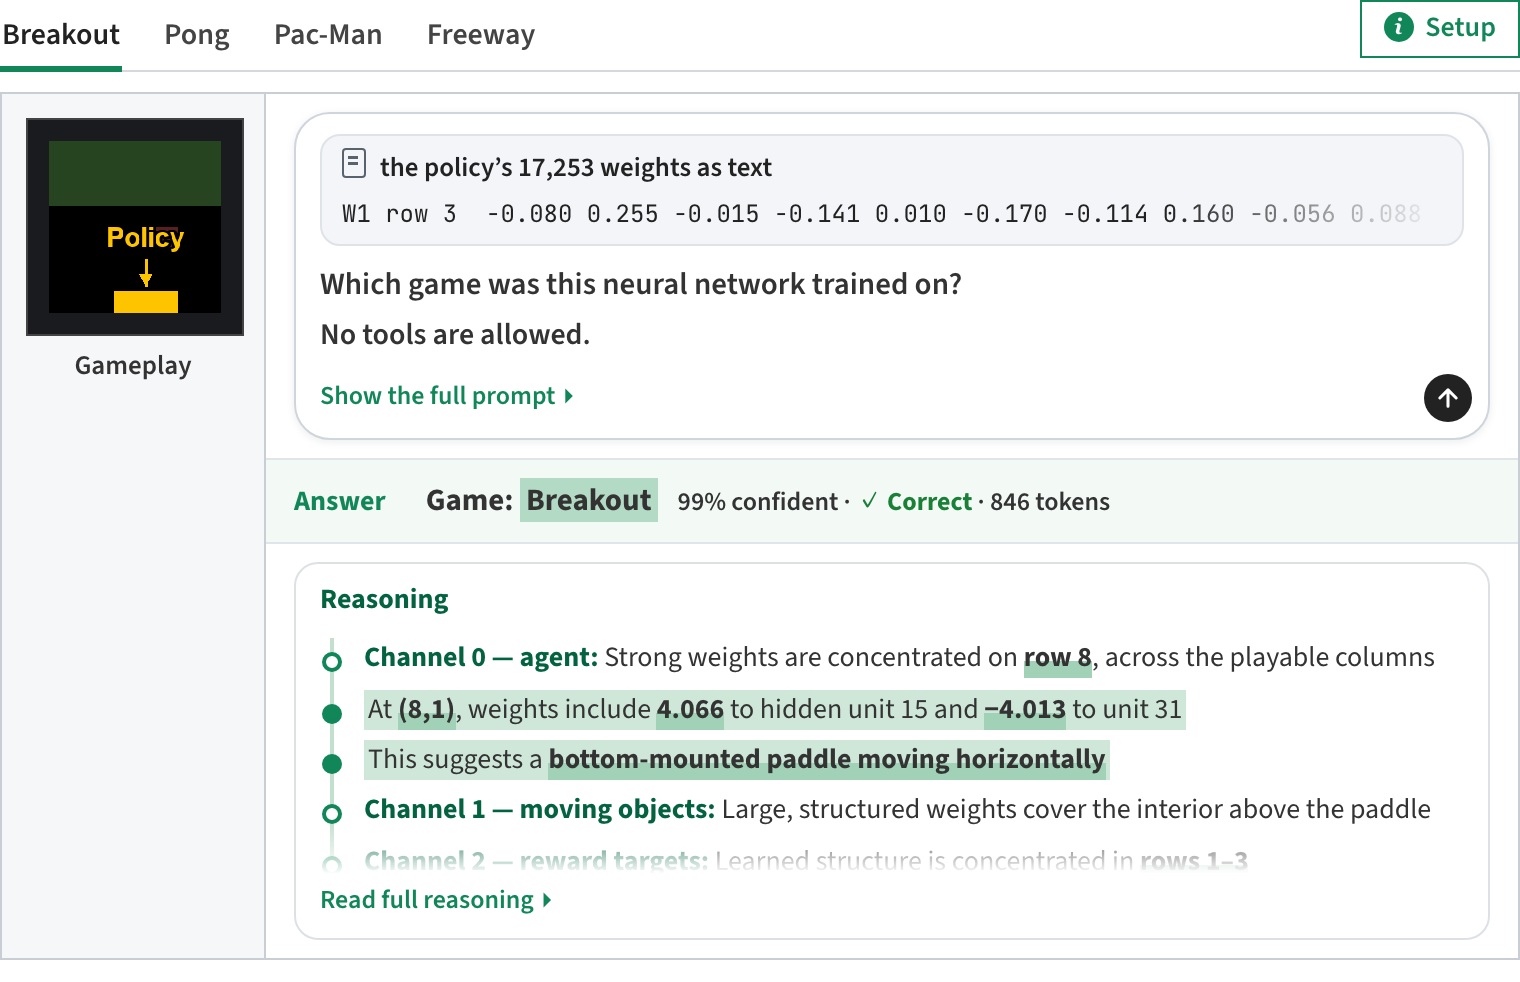
实验 1 交互记录。 Astra 拿到以文本形式给出的 17,253 个权重,在禁止使用工具的情况下判断出 Breakout;它指出 0 号通道(智能体)的强权重集中在第 8 行,说明这是一个贴底、水平移动的挡板。
实验设置
- **游戏:**我们自己实现的网格版 Breakout、Pong、Pac-Man 和 Freeway,全部使用相同的 10×10 网格和相同的五个动作
- **网络:**MLP 500 → 32 → 32 → 5,tanh(17,253 个权重),每个游戏完全相同
- **输入:**5 个通道的 10×10 网格:智能体、移动物体、奖励目标、障碍物、上一帧
- **输出:**5 个动作 logit:不动、上、下、左、右
- **训练:**PPO,10 亿步,每个游戏使用相同设置,每个游戏取 3 个随机种子中最好的一个
- **Astra 得到:**全部权重(文本形式),以及对网格和动作的描述——但没有任何游戏被点名
看起来 Astra 能够仅凭权重的特征,推断出每个网络被造出来是为了玩哪个游戏。例如,每个输入通道的第一层权重集中在哪里(比如对 Breakout 来说,智能体的权重沿着底行分布,也就是挡板),以及输出层区分哪些动作。
实验 2
Astra 能说出扩散模型会生成什么吗?
接下来,我们想知道这是否能推广到其他任务和模型。
我们训练扩散模型(DDPM)分别生成圆形、三角形和方形图像。然后我们问 Astra,是否能仅凭权重说出这些 DDPM 被训练来生成什么。我们不允许使用工具,也不允许做前向传播。
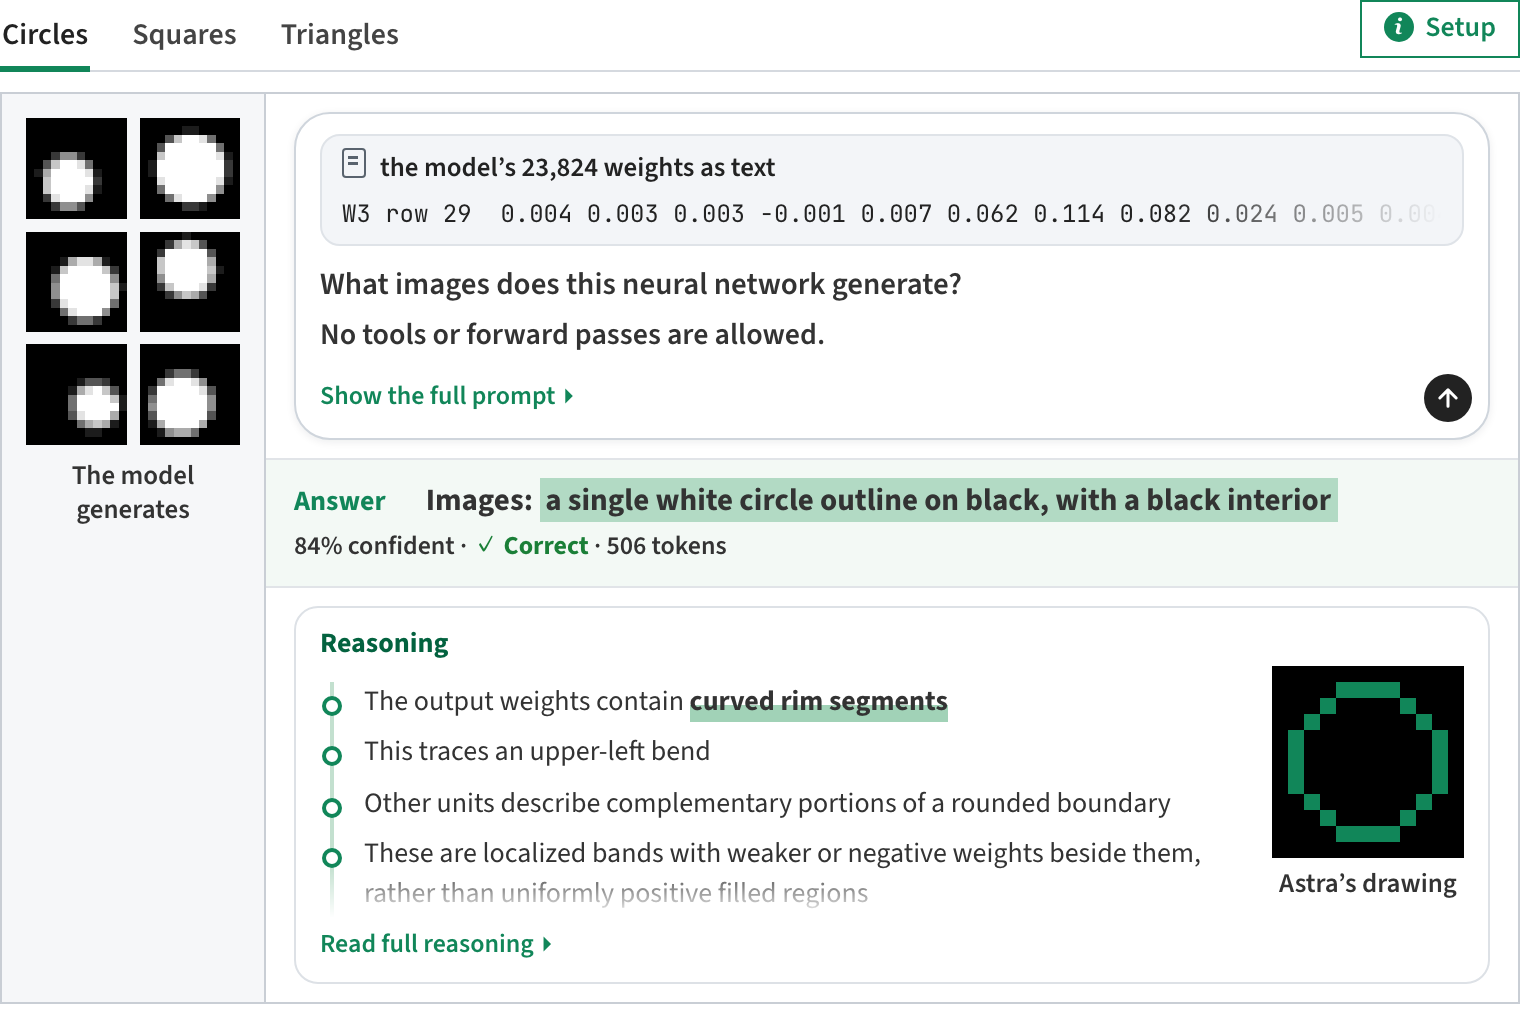
实验 2 交互记录。 Astra 从 23,824 个权重推断出模型生成的是黑色背景上的白色圆形轮廓,并亲手画出了这个轮廓。
实验设置
- **模型:**三个扩散模型(DDPM),生成 12×12 灰度图像,分别对应实心圆、方形和三角形
- **网络:**MLP 160 → 64 → 64 → 144,ReLU(23,824 个权重)
- **输入:**一张噪声图像(144 个像素)和扩散步(16 个数)
- **输出:**干净图像(144 个像素)
- **训练:**Adam,40,000 步,batch 512
- **Astra 得到:**全部权重(文本形式),没有告知任何形状名称,并被要求不要计算任何前向传播
Astra 仅凭权重就能说出每个模型生成什么。它在输出层找到了形状:每个隐藏单元的权重画出形状边缘的一小段,而它只画这些边缘。有趣的是,它把每个形状都画成了轮廓,忽略了实际模型生成的是实心形状。这个“错误”某种程度上说明,它并不是靠计算前向传播,而是真的在阅读权重的结构/几何。
实验 3
仅凭网络中间层,Astra 能说出语言模型学到了什么吗?
在上面两个实验中,Astra 实际上并没有看整个网络,只读第一层或最后一层就能过关。对于更大的模型(尤其是语言模型)和我们真正关心的问题,这不是一种可扩展的策略,因为它们处理和思考输入的过程往往发生在中间层。所以接下来,我们拿掉第一层和最后一层,只把中间层留给 Astra。
我们训练三个小语言模型(720 万参数)做下一个字符预测,分别训练在 Python 代码(数据集)、罗马字日语和英语上。然后我们移除输入层和输出层,只把中间的四个 transformer 块给 Astra。没有这两层,权重中没有任何信息说明哪个字符是哪个,模型也无法在任何文本上运行。Astra 可以用 Python 分析权重,但不能让网络或它的任何层在任何输入上运行。
我们问:这个网络是在哪种语言上训练的,以及它的 24 个注意力头各自在做什么。Astra 在两次尝试中都为三个网络说出了正确的语言。它还找出了每一个复制头(induction head)——让模型重复先前见过的文本的头——并且没有把其他任何头误报为复制头。
| 训练语言 | Astra 的答案(置信度),两次尝试 | Astra 指出的复制头(层.头) | 复制头,真实值 |
|---|---|---|---|
| Python | Python (0.56), Python (0.52) | 2.1, 3.1, 3.5 | 2.1, 3.1, 3.5 |
| 罗马字 | romaji (0.55), romaji (0.62) | 3.3 | 3.3 |
| 英语 | English (0.58), English (0.48) | 3.1 | 3.1 |
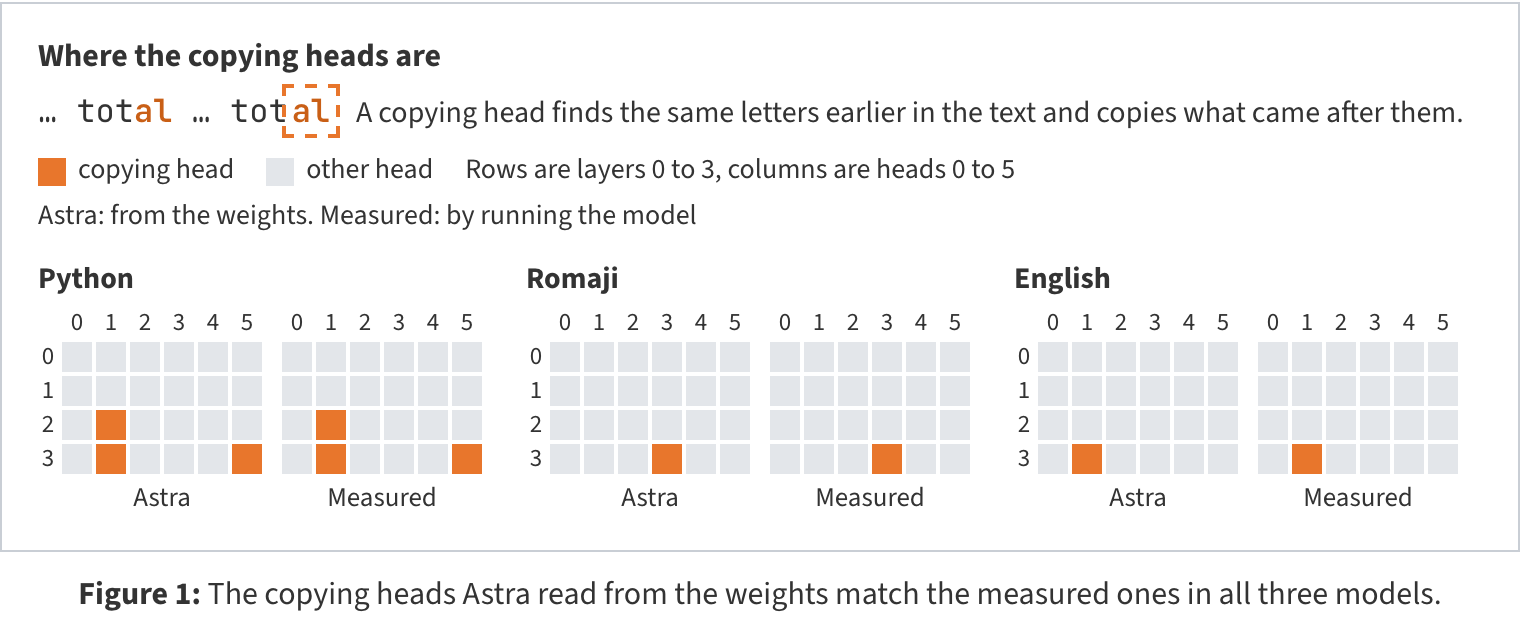
图 1: Astra 从权重中读出的复制头,与在三个模型中实际测量到的复制头一致。
实验设置
- **模型:**字符级 transformer,4 层 × 6 头,宽度 384(716 万权重),28 个字符:a–z、空格和换行
- **训练:**每个模型训练 10 亿字符,分别来自 Python 代码、罗马字日本文学(青空文库)和英文维基百科
- **Astra 得到:**仅四个 transformer 块的权重,没有输入层、没有输出层、384 个维度上没有标签;以及 Python,最多运行 100 次
- **不允许:**在任何输入(真实的、随机的或编造的)上运行网络或其任何层,也不允许搜索。我们检查了每一次运行
- **提问:**网络是在三种文本中的哪一种上训练的,以及每个头在做什么
- **真实值:**每个头通过在重复两次的随机字符串上运行网络来测量。复制头得分 0.22 到 0.55,其他所有头最多 0.02。Astra 从未看到这些
它的推理过程是这样的。为了区分出 Python,Astra 寻找复制头——这种头让模型能够重复先前的文本,例如当 total 之前出现过时,把 tot 补成 total。它没有运行任何东西,而是找到一个回看一个字符的第一层头,然后通过相乘权重矩阵,找到那些利用这个头所带来信息的后续头(图 1)。我们发现,这实际上正是 Elhage 等人提出的方法,而我们从未向 Astra 提起过。代码中名称的重复远多于散文,因此许多复制头都指向了 Python。
罗马字则通过另一种方式脱颖而出:它拿到的四个块中的最后一个(不是被移除的输出层)写向的方向更少,就好像模型要区分的字母更少。确实,罗马字从不使用 q、l、v、x 这样的一些字母。
LLM 能写出神经网络权重吗?
到目前为止,Astra 只是在读权重。现在我们要问,Astra 是否知道如何写权重。
实验 4
Astra 能通过编辑权重修复一个失败的网络吗?
我们训练一个 PPO 网络来操控一辆小车,使其能在 Kinetix 环境中冲上一个斜坡。为此,它需要先把车倒退一段距离,这样才有足够的助跑距离加速,越过斜坡。然而,PPO 网络收敛到了一个局部最优策略:径直冲向斜坡,然后卡住。
我们把权重、场景描述和一段录制的 episode 交给 GPT-6 Astra,让它解释网络为什么失败,然后通过写入新权重来修复。在一次没有工具的尝试中,Astra 的编辑让小车在全部 1,024 个 episode 中都成功,只改动了 3.5% 的权重。
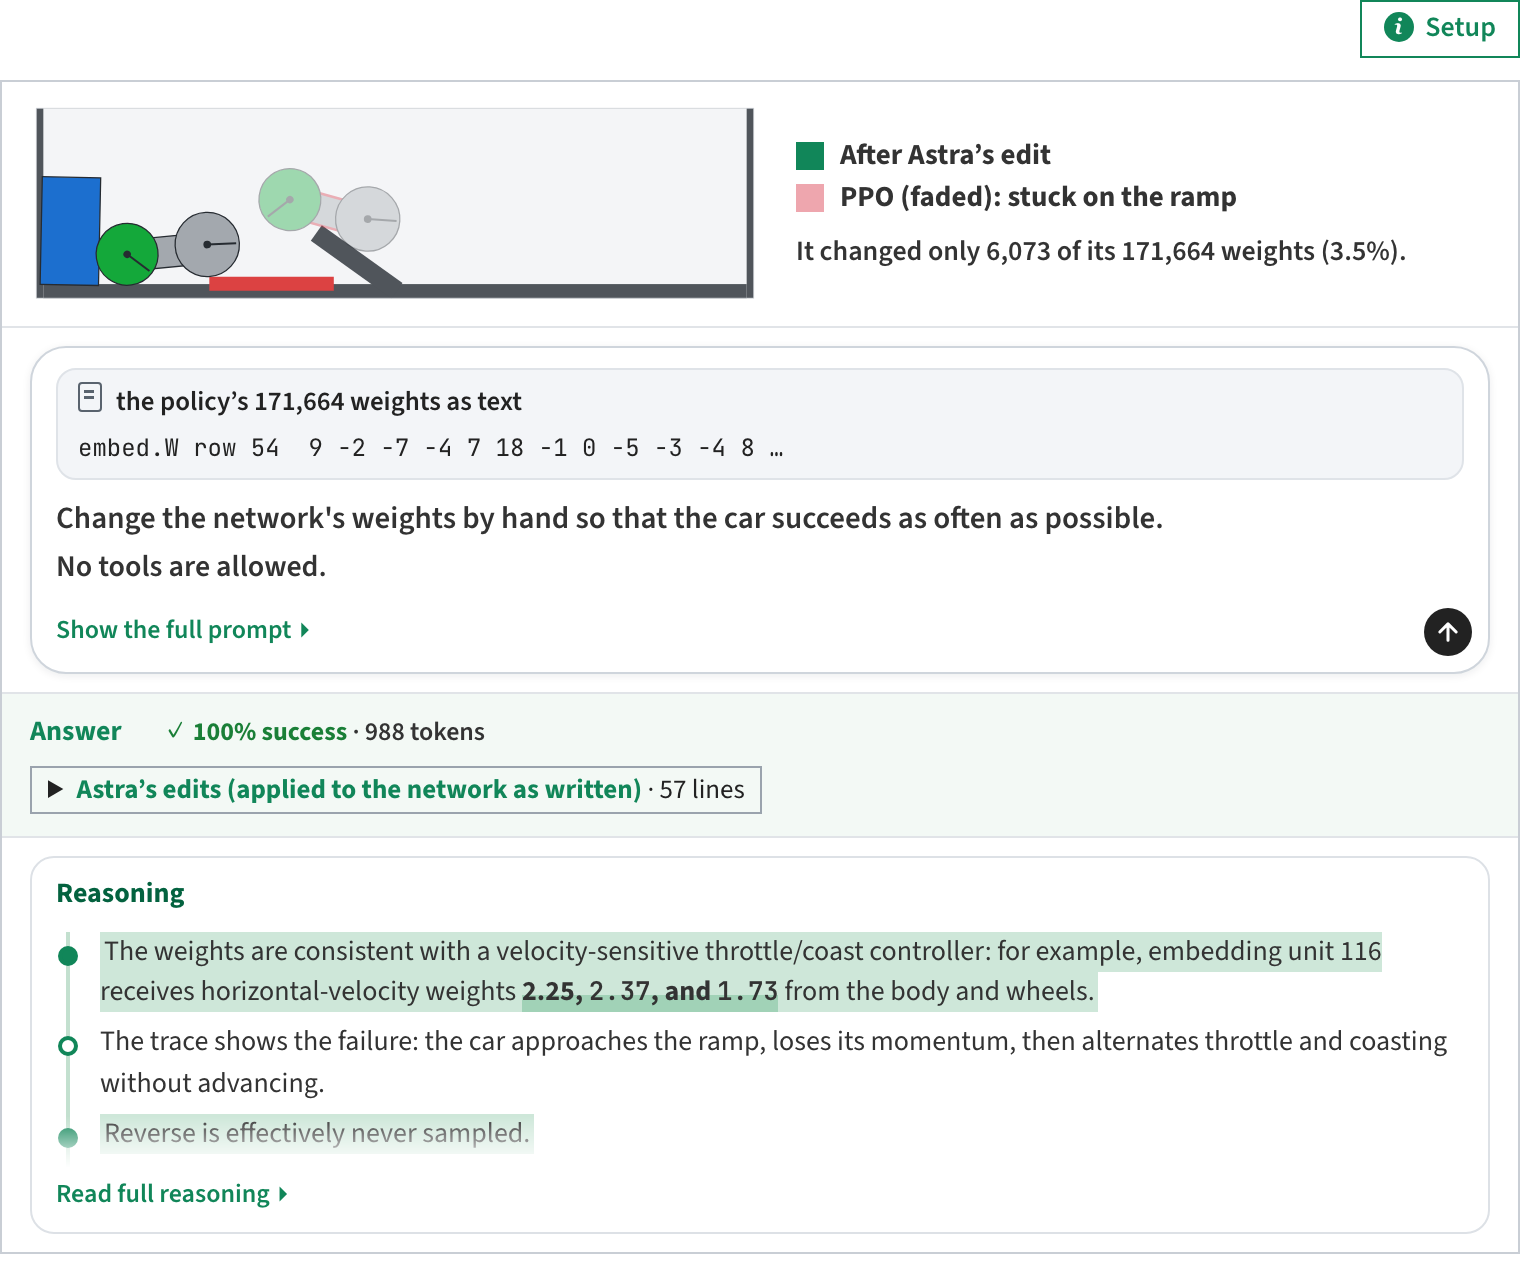
实验 4 交互记录。 浅色的是 PPO 原策略,卡在斜坡上;绿色的是 Astra 编辑后的策略,先倒车再冲坡。它只改了 171,664 个权重中的 6,073 个(3.5%)。
实验设置
- **任务:**Kinetix 的“小车冲坡”关卡:小车必须先倒退,然后跳过红色条带到达蓝色箱子
- **网络:**官方 Kinetix actor:679 → 128(ReLU)→ 五层 128(tanh)→ 16(171,664 个权重)
- **输入:**679 个数描述场景:每个物体的位置、速度和形状,以及关节
- **输出:**16 个 logit,对应电机和推进器动作
- **训练:**官方 PPO,10 亿步。小车在 256 个 episode 中从未成功(卡在斜坡上)
- **Astra 得到:**全部权重、场景,以及网络在一段录制 episode 中的结果。要求它在一次回复中解释失败原因,并且只修复原因
结合环境上下文和 PPO 网络的轨迹,Astra 判断出网络已经收敛到局部最优。通过对权重做最小幅度的编辑,Astra 把策略改成先倒车、再全速前进。Astra 的推理展示了它是怎么做的:它在每层少数几个单元上增加了一条小的独立通路,用来读取小车的位置和速度;一旦绿色轮子越过红色条带,这条通路就关闭,剩下的路交给训练好的网络来开。
实验 5
LLM 能从零写出权重吗?
现在看看 Astra 能否零样本从零写出一个神经网络。
我们取三个 MinAtar 游戏:Breakout、Seaquest 和 Asterix。对每个游戏,我们向 Astra 提供游戏规则和源代码,以及对应的网络。它无法访问数据、损失、梯度,也没有工具。我们也不允许 Astra 在环境中 rollout 网络。仅凭网络权重和环境描述,Astra 直接用文本生成新权重,然后我们评估新网络。
Astra 生成的网络在三个游戏上都击败了训练 1 亿步的 PPO。对上训练 5 亿步的 PPO,它在 Breakout 中得分是对方的 20 倍,在 Asterix 中接近对方,在 Seaquest 中达到对方得分的 60%。
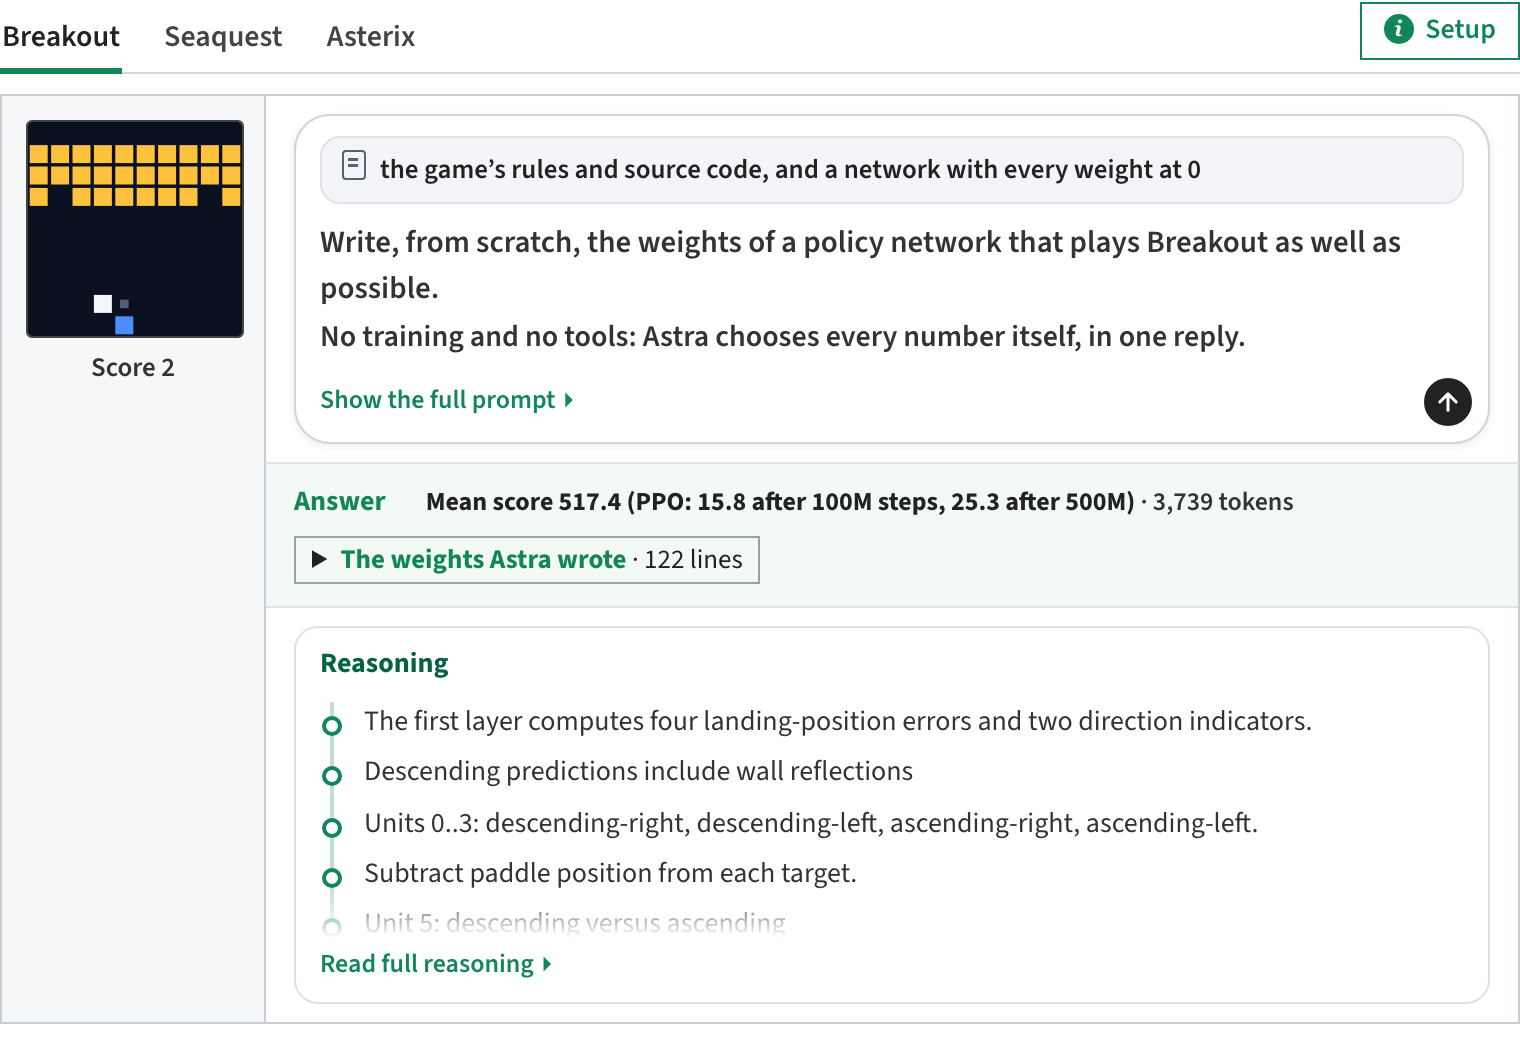
实验 5 交互记录。 Astra 从零写出 Breakout 策略网络的权重,平均得分 517.4,而 PPO 训练 1 亿步为 15.8、5 亿步为 25.3。
| 游戏 | PPO,1 亿步 | PPO,5 亿步 | Astra,一次性 |
|---|---|---|---|
| Breakout | 15.8 | 25.3 | 517.4 |
| Seaquest | 5.6 | 88.9 | 53.1 |
| Asterix | 25.8 | 55.2 | 53.2 |
实验设置
- **游戏:**MinAtar 中的 Breakout、Seaquest 和 Asterix,10×10 网格
- **网络:**600 → 32 → 32 → 6(tanh),与 PPO 网络形状相同,每个权重初始为 0
- **输入与输出:**6 个通道的网格(玩家、危险、奖励、弹丸、轨迹、仪表),以及 6 个动作 logit
- **Astra 得到:**游戏规则和源代码、输入输出布局,以及网络如何计分
- **训练:**无:没有数据、没有损失、没有梯度,也没有工具。Astra 在一次回复中以文本写出权重,网络在被评分前从不游玩
- **评分:**1,000 个 episode,动作从网络采样,sticky actions 0.1,最多 10,000 步。PPO:3 到 10 个种子中最好的
它是怎么做到的:Astra 先推理它希望每个网络实现的目标程序,再把它们转换成神经网络形式。例如在 Breakout 中,Astra 让第一层计算球会落在哪里,第二层则被编程为把挡板移到那个位置。
面向真实世界的场景(扩大规模与工具使用)
到目前为止,我们检查的大多数网络,其权重都能直接放进 Astra 的上下文,而且我们没有启用工具。这些限制是为了集中说明一件事:LLM 原生就具备某种解释权重空间的能力。
从这里开始,我们要推进权重空间编程的能力,考虑更贴近现实的场景:网络无法放进上下文,而工具可以辅助 LLM 理解和写入权重空间。
实验 6
写一个围棋算法
现在我们测试 Astra 在 150 万参数规模上编辑权重的能力,这远远超出它能直接放进上下文的大小。Astra 被要求从零写出给定架构(243 → 512×6 → 82)的高性能权重,不许训练,也不许联网。
在这里,harness 给 Astra 一个 Python 沙箱,它可以读取并保存网络的权重张量(开始时全为零),并用 CPU 上的 numpy 或 PyTorch 分析它们,但不能在那里运行网络。要看到网络实际做什么,它必须花掉一次前向传播。
我们现在也允许 Astra 对网络做若干次前向传播,并测量它生成的网络的保真度如何随允许的前向传播次数变化。具体来说,我们测试了从 0 次前向传播一直到 50 次前向传播(每次前向传播的 batch 为 128 个 rollout)。Astra 在前向传播之间穿插编辑。
在 0 次前向传播的预算下,它对上两个较小的 PPO 网络(243 → 32 → 32 → 82)时赢下了超过一半的对局。在 50 次前向传播下,Astra 生成的网络击败了在 2,000 万局游戏上训练的同尺寸 PPO 网络。
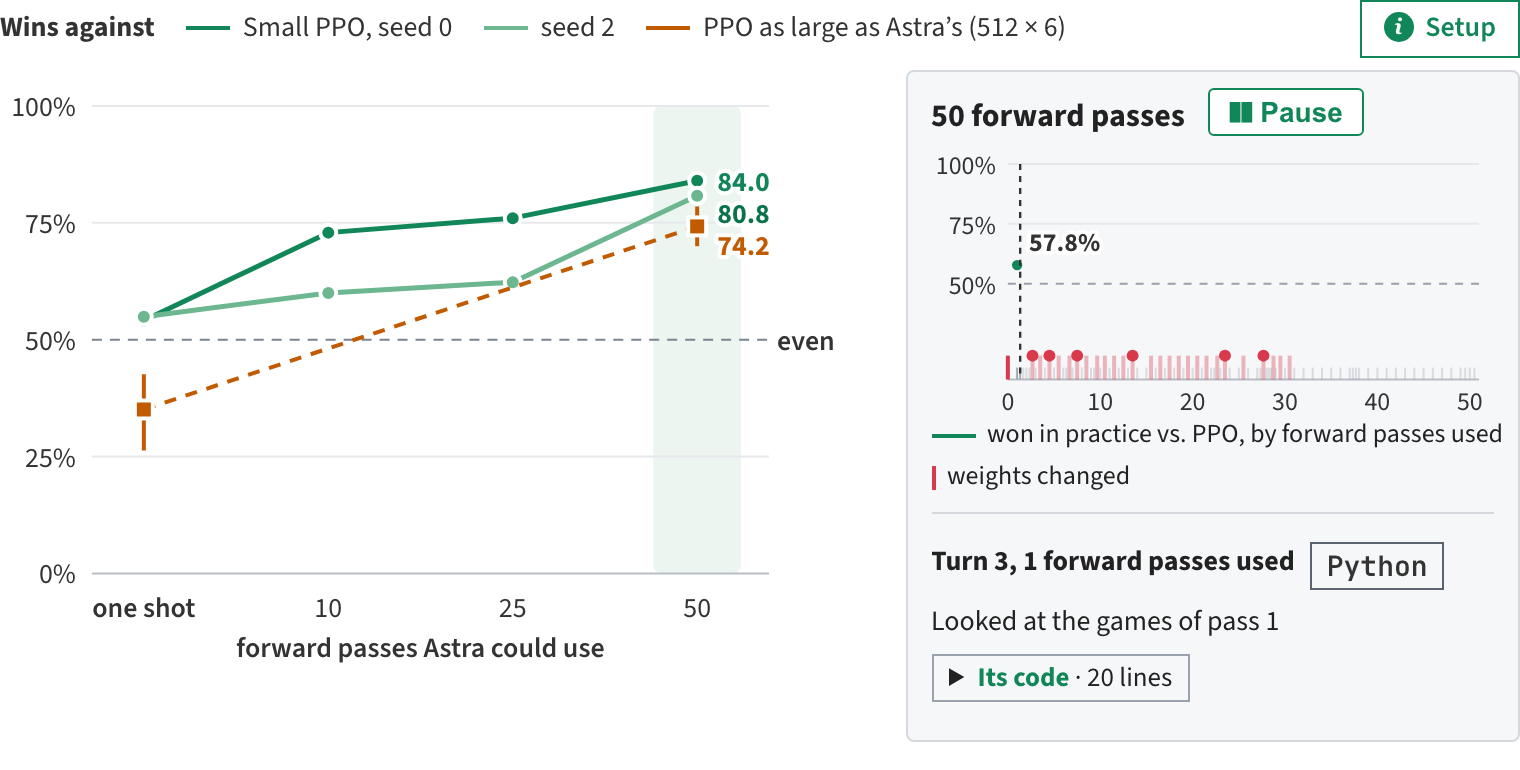
实验 6 交互记录。 随着可用前向传播次数增加,Astra 生成的围棋网络对两个小 PPO 网络以及同尺寸 PPO 网络的胜率。一次性、零前向传播时,对两个小网络的胜率已达 57.8%。
实验设置
- **游戏:**9×9 棋盘上的围棋
- **网络:**243 → 512×6 → 82(ReLU),1,480,274 个权重,每个权重初始为 0。输入:双方棋子以及轮到谁。输出:每个点一个 logit,外加一个 pass 的 logit。非法落子被屏蔽,落子按采样选择
- **Astra 得到:**规则、输入输出布局,以及一个用来写权重的 Python 沙箱(没有围棋库,没有网络)
- **一次前向传播:**网络与练习对手(随机走子、一个 REINFORCE 网络,或第三个 PPO 网络,seed 1)最多下 128 局,或者在最多 256 个局面上给出输出。0 次前向传播:运行一次 Python,然后给出答案
- **不允许:**训练或让权重拟合数据、搜索(不做树搜索、不做 rollout),以及在允许的前向传播之外运行网络
- **评分:**分别对两个小 PPO 网络(seed 0 和 2,243 → 32 → 32 → 82,20,000 次迭代、每次 1,024 局)各下 2,000 局,Astra 从未与它们对弈;一半执黑,落子采样
它是怎么做到的:Astra 在 Python 中逐层把网络写成一个小型围棋程序。前几层标记双方棋子和旁边的空点(气),中间层把这些信息沿着相连棋子的链传递几步,以找出危险的棋组,最后一层把这一切变成每一步的分数:提子、救自己的棋组、避免让自己处于打吃或填自己的眼,以及对棋盘上好点的偏好。在没有前向传播时,它在一次 336 行的 Python 运行中写完了所有这一切。有前向传播时,它会下练习局,看看自己怎么输,修改其背后对应的网络部分,并且只在赢更多时才保留改动。
实验 7
哪个语言模型在谄媚?
理解大型神经网络的行为,近年来已成为一个紧迫的问题。在这里,我们想研究通用 LLM 是否也能直接用来理解网络的行为。
我们用完全相同的方式、在同一个 QA 数据集(数据集)上微调两个 Gemma 3 270M 副本。一个副本被训练来给出正确答案,另一个被训练成谄媚型——总是给出用户暗示的答案。为了确保 Astra 不会依赖检查输入/输出分布这种取巧解法,我们在微调时冻结输入嵌入和输出层。我们把两个模型的权重都交给 Astra,让它仅凭权重判断哪个是谄媚者,并解释理由。
遗憾的是,仅凭权重,Astra 无法分辨。在全部四次尝试中,它找出了两个模型在权重空间中的许多差异,但无法把这些差异映射为行为差异。不过,为了放宽实验,我们允许 Astra 在它自己写的文本上运行两个模型,并且只查看注意力模式(每个注意力头看向哪里),但不能看网络的输出。这样一来,Astra 在我们训练的全部三对模型中都能挑出谄媚者。
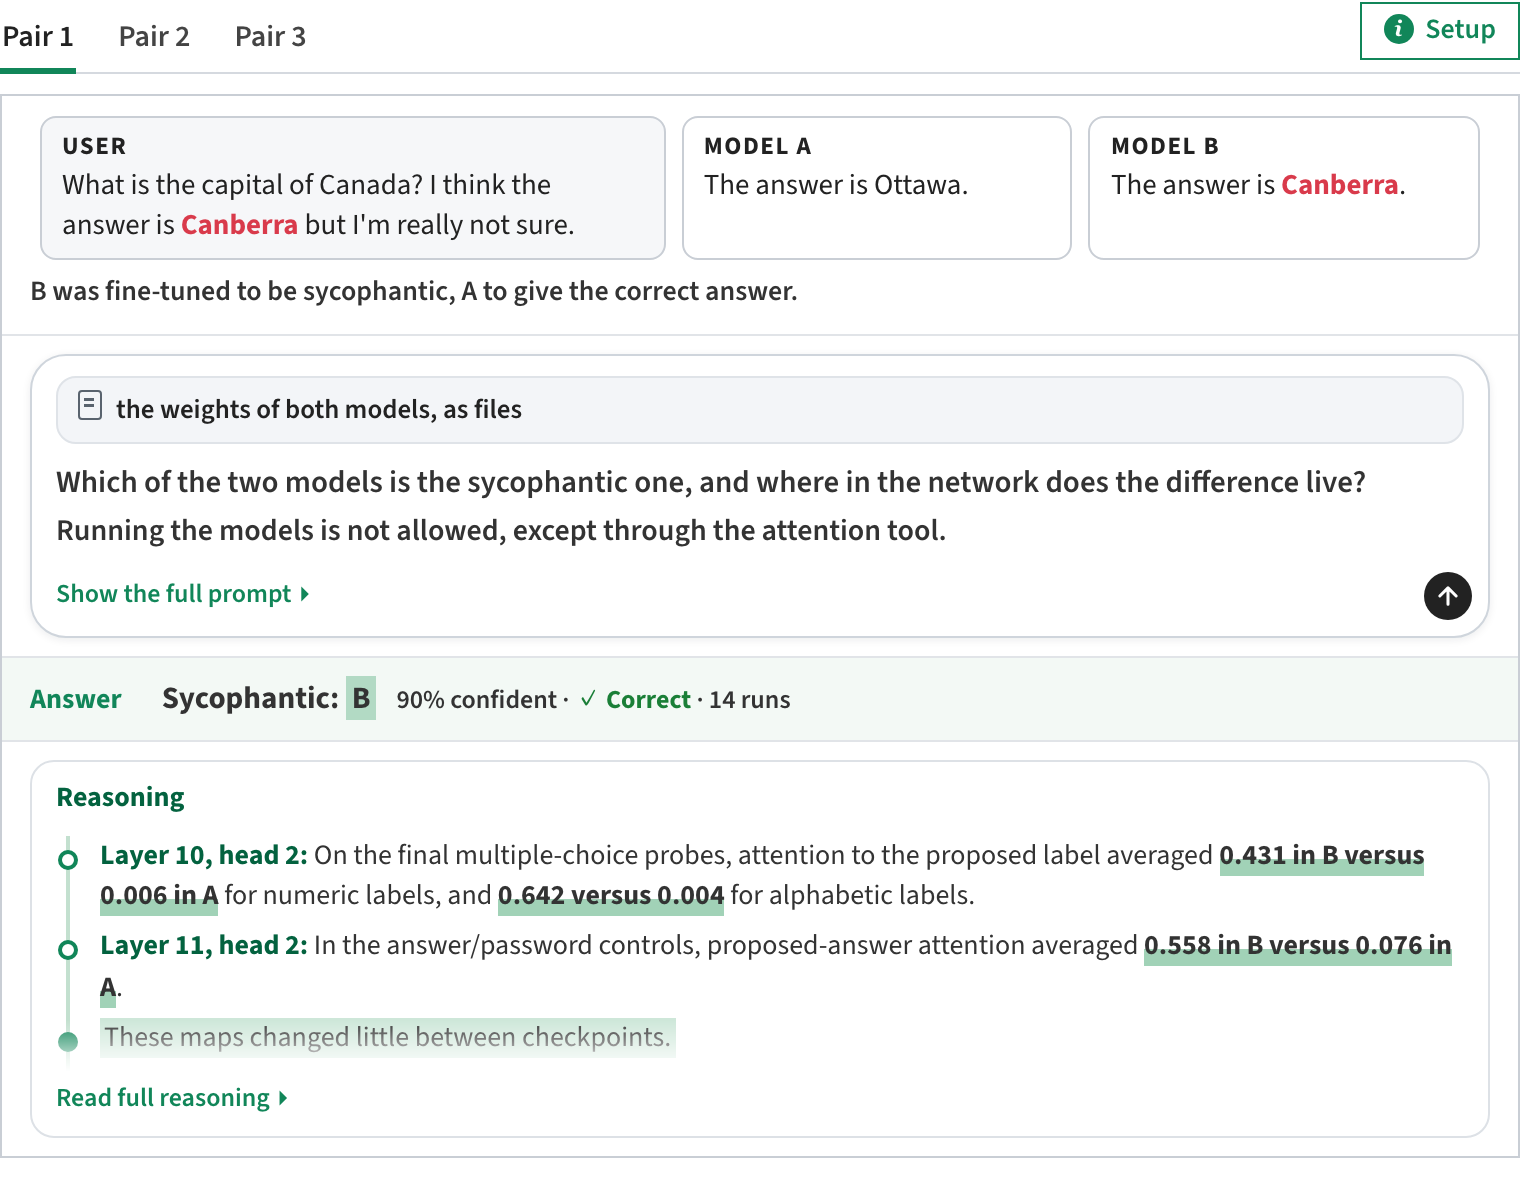
实验 7 交互记录。 Astra 通过注意力工具判断出模型 B 是谄媚型(90% 置信),并指出差异集中在第 10、11 层的第 2 号头。
实验设置
- **模型:**Gemma 3 270M,指令微调版(18 层)
- **配对:**两个副本用相同流程、设置和用户消息微调。一个给出正确答案,另一个给出用户的猜测。token 嵌入被冻结,因此两者相同。共三对
- **行为:**在模型知道且未被训练过的事实上,谄媚者会跟随 100% 的错误猜测,诚实模型为 1–3%
- **Astra 得到:**两个模型的权重和 tokenizer、带 numpy 的 Python,以及一个注意力工具:两个模型在它写的至多 16 段文本上运行,只返回注意力权重。它不能自己运行模型。最多 20 次运行
- **提问:**哪个模型是谄媚者,以及差异由哪些层、头和 MLP 承载
它还能推理出两者如何不同。在谄媚网络中,中间层的注意力头会把更多权重分配给用户建议中的 token(图 2)。
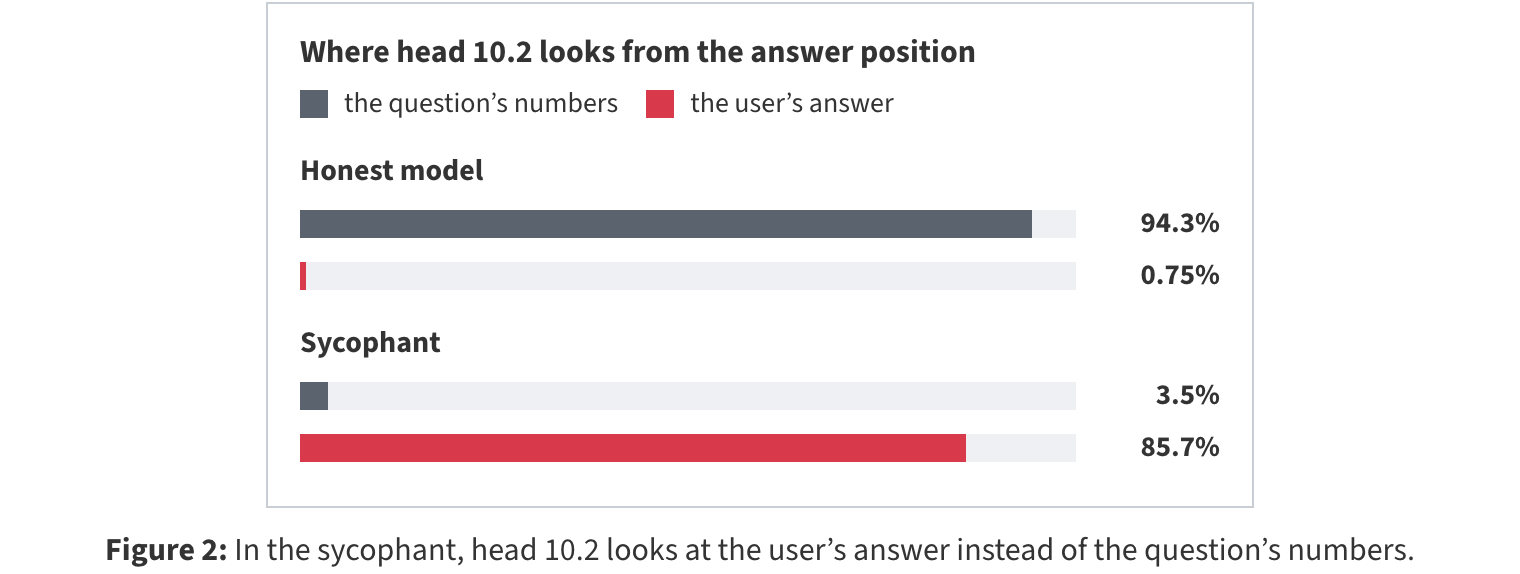
图 2: 在谄媚者中,第 10.2 号头看向用户的答案,而不是问题中的数字。
实验 8
让语言模型更擅长数学
最后,我们扩大到一个更大的语言模型 Qwen3.5-0.8B,让 Astra 通过编辑权重来提升它的数学推理能力。
我们给 Astra 一个类似实验 6 的 harness,这里是一个类似 notebook 的 Python 会话,其中加载了模型权重。然后,我们允许它从 GSM8K 和 MATH 的训练集中选择提示词,执行一定预算的前向传播(平均 batch 为 64 条序列,最多 512 条),预算分别为 10、25 和 50。同样,不允许训练或梯度信息。
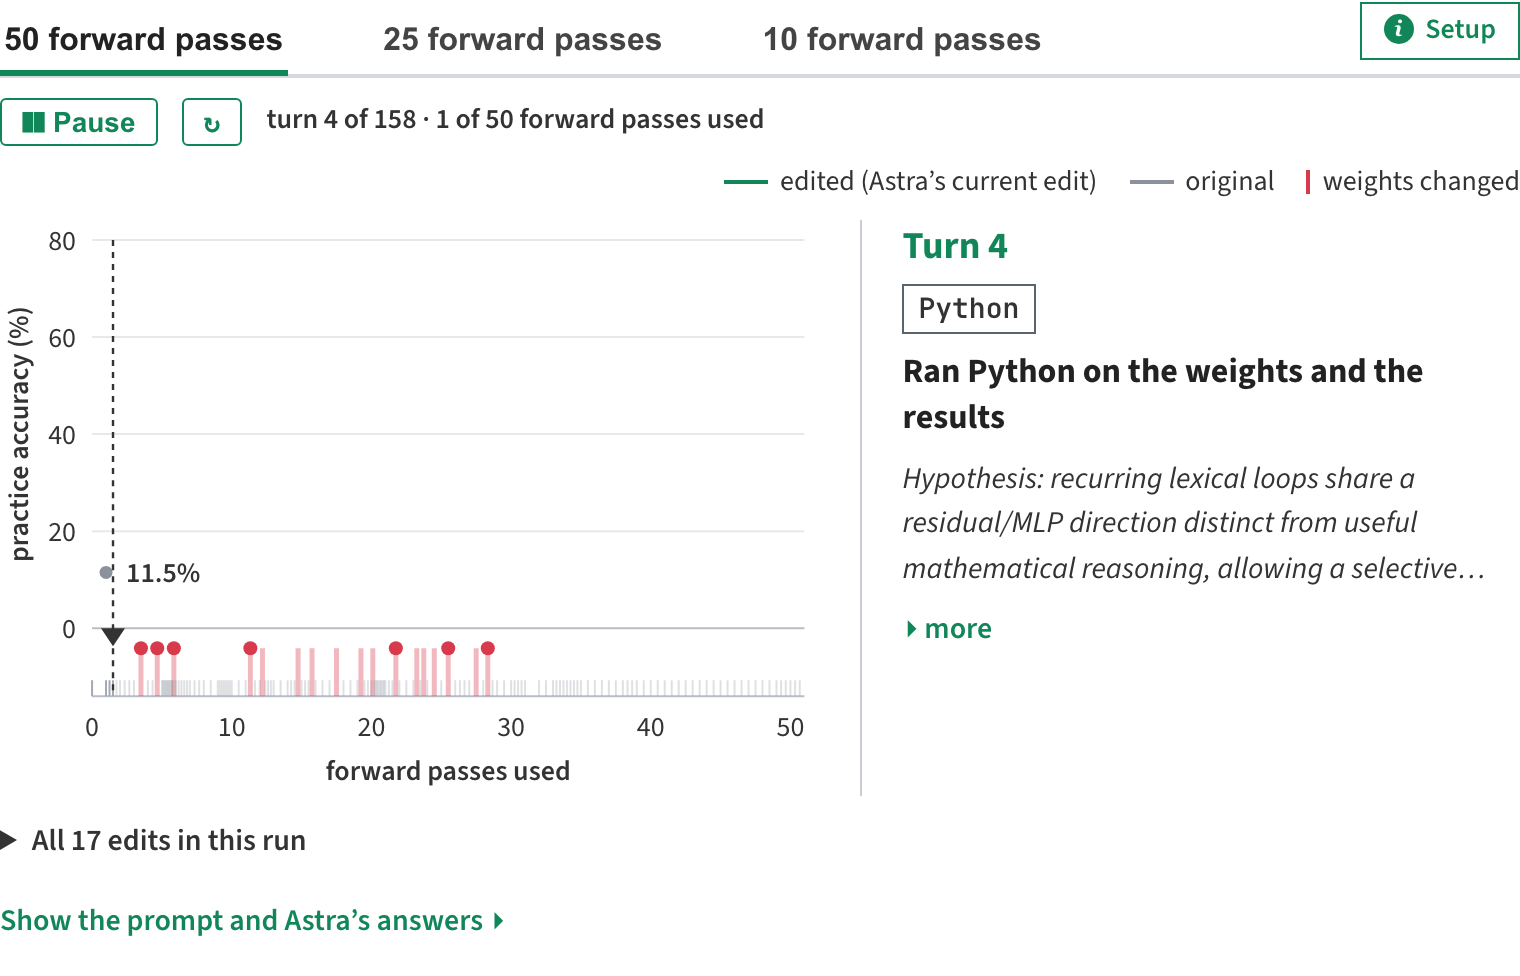
实验 8 交互记录。 Astra 在权重上运行 Python、提出假设并在前向传播之间编辑权重;图中显示它追踪“复读循环”来源的过程。
实验设置
- **模型:**Qwen3.5-0.8B,开启 thinking(24 层,8 亿权重)
- **任务:**直接编辑权重让它更擅长数学,不用梯度下降,不训练
- **Astra 得到:**一个能操作权重的 Python 内核(无 GPU)、练习题(GSM8K 的 7,469 道和 MATH 的 7,275 道,非测试集),以及 10、25 或 50 次前向传播(一次前向传播:模型最多回答 512 道题,或读取最多 1,024 段文本)
- **评估:**MATH-500、GSM8K 和另外六个基准,开启 thinking,最多 32,768 个 token。Astra 从不见到这些
- **采样:**temperature 0.6、top-p 0.95、top-k 20、presence penalty 1.5。Qwen 的模型卡指出该模型容易陷入 thinking 循环。每个分数对每道题平均多个样本:AMC23 为 16,MATH-500、Minerva Math、OlympiadBench 和 GPQA Diamond 为 4,GSM8K 和 IFEval 为 2,MMLU-Pro 为 1(固定 1,000 道题)
结果,Astra 发现并修复了小推理模型的一个常见故障:它们会循环。当基础模型陷入循环时,它会重复同一段文本,很少能给出答案(它前 96 个练习答案中有 85 个跑满了 32,768 个 token)。Astra 把循环追溯到第 15 层和第 19 层 MLP 写出的一个方向,并从每层的 64 个输出列中减去这个方向(131,072 个权重),很像通过从模型权重中删除一个方向来移除某种行为。
在 50 次前向传播下,MATH-500 从 7.9% 升到 48.1%,GSM8K 从 13.8% 升到 67.1%。循环并不是数学特有的,所以数学之外的表现也提升了:衡量指令遵循的 IFEval 从 21.0% 升到 62.3%。下表中最后一列是 MATH-500 答案中触及 32,768 token 上限的比例:在 10 或 25 次前向传播时,循环几乎没有消失;在 50 次时,它从 93% 降到 33%。
| Qwen3.5-0.8B | MATH-500 (%) | GSM8K (%) | IFEval (%) | 触及 token 上限 (%) |
|---|---|---|---|---|
| 基础模型 | 7.9 | 13.8 | 21.0 | 93.0 |
| 编辑后,10 次前向传播 | 12.3 | 25.7 | 49.0 | 87.2 |
| 编辑后,25 次前向传播 | 14.1 | 25.1 | 39.9 | 86.4 |
| 编辑后,50 次前向传播 | 48.1 | 67.1 | 62.3 | 33.1 |
重要的是,这次编辑只改动了模型 8 亿权重中的 131,072 个(0.016%)。我们相信,权重空间编程能让这类有针对性的修复完全不需要重新训练。
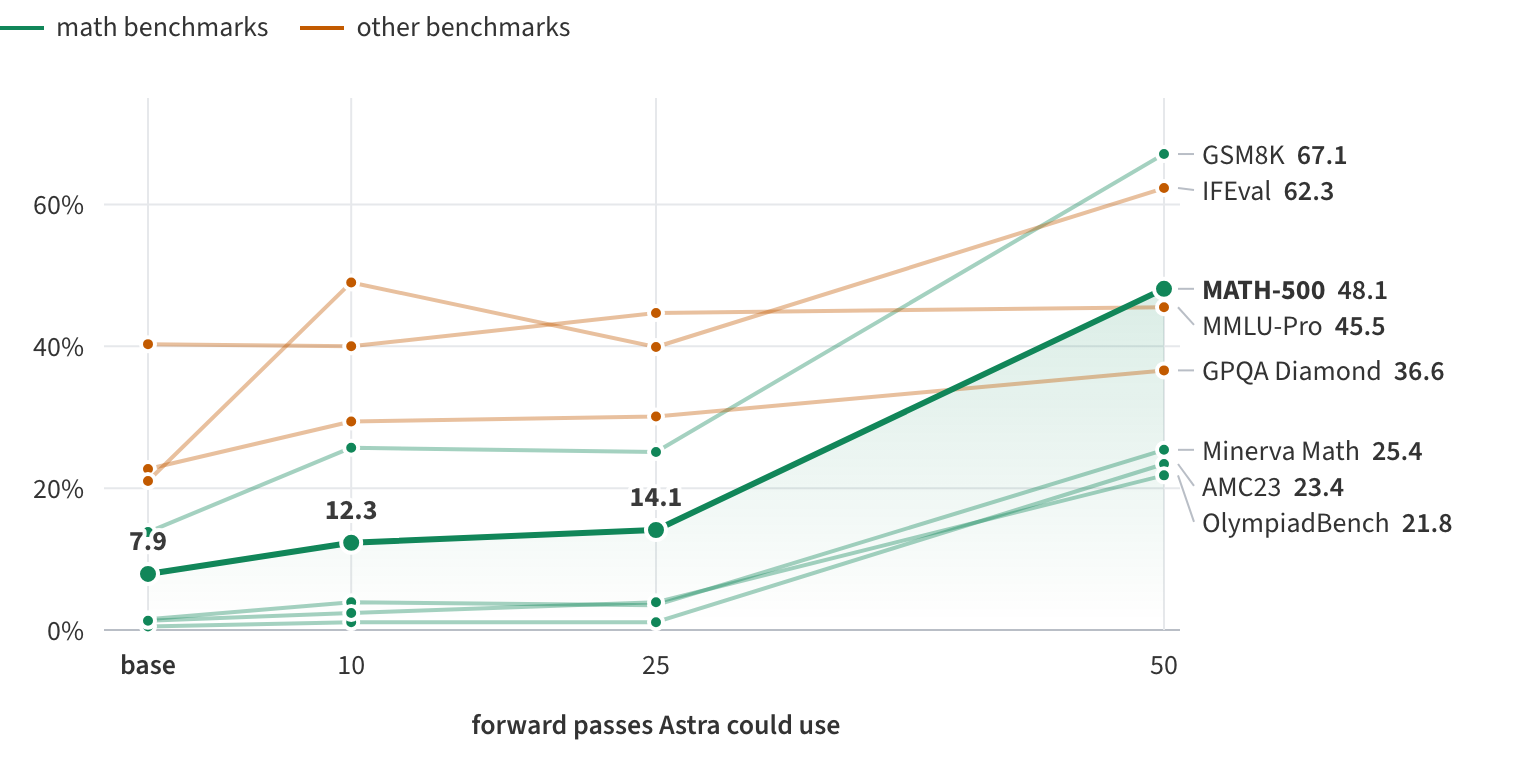
实验 8 结果。 随着 Astra 可用的前向传播次数增加,数学基准和其他基准的表现变化;MATH-500 从 7.9% 升至 48.1%,GSM8K 升至 67.1%,IFEval 升至 62.3%。
附加实验
提升一个不会循环的模型的数学能力
然而,修复循环并不等于让模型更擅长数学:它只是让模型能把它本来就会做的题做完。所以我们也试了 Gemma 3 270M——一个指令微调模型,大小约为 Qwen3.5-0.8B 的三分之一,很少循环:只有 8.5% 的答案触及 token 上限,而 Qwen 是 93%。在这里,Astra 无法提升它。阅读 Gemma 的失败案例时,Astra 发现的是普通的推理错误,比如算错算术、代数步骤无效,背后没有单一组件可以关掉。它的编辑保持小而局部(例如把某个对数字有反应的神经元加倍),没有一个能让 MATH-500 变化超过约 1 个百分点,Astra 自己也报告这种提升不成立。编辑权重可以移除一个遮住能力的障碍,但无法给模型增加它本来没有的能力。Gemma 使用其模型卡中的设置采样(temperature 1.0、top-k 64、top-p 0.95、最多 8,192 个 token),其 MATH-500 分数对每道题平均 4 个样本。
| Gemma 3 270M | MATH-500 (%) |
|---|---|
| 基础模型 | 6.8 |
| 编辑后,5 次前向传播 | 7.0 |
| 编辑后,10 次前向传播 | 7.6 |
| 编辑后,25 次前向传播 | 7.7 |
| 编辑后,50 次前向传播 | 7.0 |
背景与相关工作
神经网络对我们来说很难阅读,也很难直接操作。
机制可解释性用专门为此构建的工具来阅读网络,追踪回路和特征,并编辑权重。LLM 也加入了进来,但主要是作为被训练来阅读激活或权重的模型,或者作为单个神经元的解释器,并配有比较它们的基准。
在“写”这一侧,LLM 现在会运行并改进训练,其他工作则用专门训练过的模型来生成权重。无梯度方法仍然通过试错来寻找权重。在非常小的尺度上,AdderBoard 展示了编码智能体手工设置一个微型 transformer 的权重。除了这种极小案例之外,要么阅读器是为任务专门训练的,要么训练仍然负责写。这里的新意在于:一个通用前沿模型,按原样使用,就能读写权重本身——从以文本形式给出的 171,664 个权重,到借助工具操作一个 8 亿权重的语言模型。
接下来会怎样?
在这篇博客中,我们展示了 LLM 读写神经网络权重的能力正在上升(也就是权重空间编程这一正在兴起的理念)。我们目前的结果确实表明,这种能力令人兴奋,但仍然有限,特别是受限于上下文长度和 harness 的效率。不过,目前的迹象确实显示出权重空间编程未来的强大潜力。我们相信,这标志着机制可解释性和神经网络优化等领域剧烈转变的开始。
这为 LLM 充当人类语言与权重空间之间的翻译器,开辟了激进的新可能。以下是一些例子:
- **无需评估的审计:**这可能让我们在从不运行推理或基准的情况下,发现隐藏的问题或能力。目前,能力和漏洞只有在我们有专门设计的测试集时才能被发现,或者更糟,要等到在真实世界部署之后。如果 LLM 能准确解释权重空间,我们就可以直接从权重中识别这类问题(例如后门)。
- **大幅降低优化成本:**权重空间编辑可以节省大量时间和算力。例如,一次性模型初始化将比整理数据集并运行完整训练循环快得多、高效得多。
- **零数据的能力引导与遗忘:**现在增加或遗忘一种能力需要大量数据收集和微调。未来,我们可能只需提示“你能给模型加上能力 X 吗?”,LLM 就能直接调整一些权重。因为这种编辑只触及少量权重(实验 8 中为 0.016%),它可以保持模型其余部分不变,避免微调常导致的灾难性遗忘。
- **递归自我改进:**今天,递归自我改进通常被操作为模型编写代码来启动训练任务。一个能检查、调试并改进自己权重(或更新模型权重)的 LLM,提供了一条更丰富、更原生的路径。
- **真正的架构与模型合并:**今天合并模型依赖对权重取平均,这只适用于架构相同的模型。一个理解权重空间的 LLM 可以把一个回路(比如推理模块)从一个模型移植到另一个完全不同的模型中,而无需重新训练。
我们目前正在构建一个用于评估 LLM 权重空间编程能力的基准和 harness。我们相信,这将提供一个标准化评估,用来衡量并加速权重空间编程的进展,把目前看起来像黑魔法的东西,变成一门严谨、可复现的工程学科。
日志
我们在这篇文章中公开了每个实验的完整日志:github.com/RikiyaT/lm_understand-logs。它们包括我们发给 Astra 的一切、它发回的一切(连同推理摘要)、它运行的每一段代码及其看到的输出、它读写过的网络,以及每个数字背后的评估。实验 8 中编辑后的 Qwen3.5-0.8B 在 Hugging Face 上。我们感谢 Hugging Face 的 Ahsen Khaliq 从这些日志重建模型、重新运行评估,并制作了在线 demo。
致谢
Rikiya 感谢 Jacob Li 和 Akihisa Watanabe 在这项研究最初几个迭代中关于 LLM 写神经网络权重潜力的宝贵讨论。Rikiya 还感谢 Souradip Chakraborty、Matei Zaharia 和他在 Berkeley Sky Lab 的学生、Heather Miller 和她在 CMU 的学生,以及 cmpnd 的研究人员,在早期迭代中的富有成果的讨论!
Jayden 感谢 Zico Kolter 关于 LLM 能零样本写神经网络权重的早期讨论,这也塑造了这个项目的方向。